Eigene Daten, Datei für Datei: woher die Trainingsdaten der 15 Netze stammen
Diesen Beitrag anhören15 Min.
Von KI aus dem Text dieses Beitrags erstellt und von der synthetischen Stimme „Sulafat“ gelesen; keine wörtliche Fassung, Fehler sind möglich.
Wird geladen …
Von KI aus dem Text dieses Beitrags erstellt und von der synthetischen Stimme „Sulafat“ gelesen; keine wörtliche Fassung, Fehler sind möglich.Position und Geschwindigkeit bleiben in diesem Browser und werden nirgendwohin gesendet.
Die Aufnahme konnte nicht abgespielt werden. Audiodatei öffnen
Der Beitrag „15 Netze in 40 Tagen: die Ahnenreihe der Bewertung“ führte jedes Netz auf, das das Orakel bis zum 2026-10-18 auf den Hauptzweig übernahm, und nannte seine Lücken, darunter nicht belegte Lehrer. Im Auftrag des Betreibers prüfte danach eine interne forensische Prüfung, nur lesend, woher die Trainingsdaten aller 15 Netze stammen. Das Ergebnis: Alle 15 Netze sind mit eigenen Daten des Projekts trainiert. Das ist für jede Datendatei belegt und durch nachgerechnete Partien gestützt. 2 Toleranzfälle nach der Verfassung des Projekts und 6 Grenzen gehören zum Ergebnis; sie stehen unten. Der frühere Beitrag behält seinen Text und verweist jetzt auf diesen; dieser Beitrag, ebenfalls im Auftrag des Betreibers geschrieben, ergänzt und berichtigt ihn.
Wer die Daten erzeugte
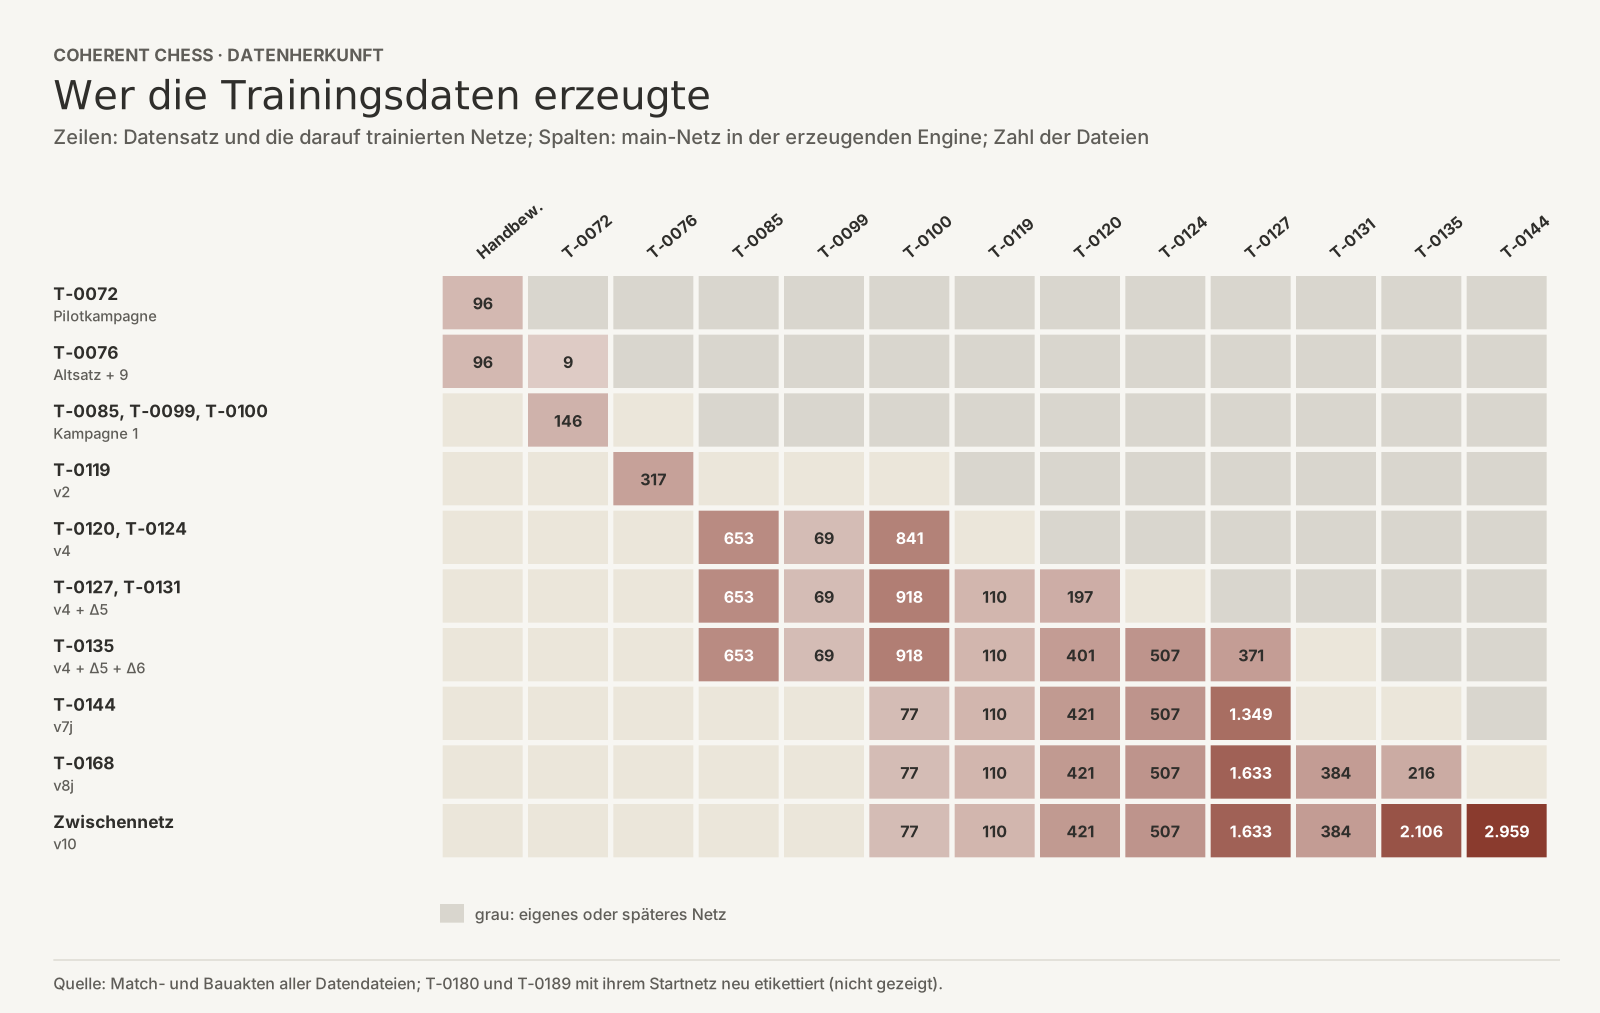
Jede Datendatei stammt aus Partien, die eine Engine des Projekts gegen sich selbst spielte und bewertete. Das Diagramm zeigt je Trainingsdatensatz, welches Netz des Hauptzweigs in den erzeugenden Engines steckte, gezählt in Dateien. Alle belegten Zellen liegen in Spalten früherer Netze oder der handgeschriebenen Bewertung, die dem ersten Netz vorausging. Kein Datensatz enthält Dateien einer Engine mit dem eigenen oder einem späteren Netz und keiner Dateien von außerhalb des Projekts. Die Matrix zählt Originaldateien nach der Bewertungsquelle in der erzeugenden Engine: die handgeschriebene Bewertung oder eines von 12 früheren Netzen des Hauptzweigs. Die zusätzliche Replay-Datei der Kampagne 1 ist nicht dargestellt; beim Altsatz bezeichnet 96 seine Herkunftsdateien aus der Pilotkampagne.
| Lauf | Datensatz | Datenzeilen | Startgewichte |
|---|---|---|---|
| T-0072 | Pilotkampagne, 96 Dateien, 96.000 Partien | 6.946.527 nach Entdoppelung | Seed |
| T-0076 | Altsatz (die Stellungen von T-0072) und 9 Dateien der Kampagne 1 | 20.875.984 | Seed |
| T-0085, T-0099, T-0100 | Kampagne 1: 146 Dateien und 1 Replay-Datei | 226.723.955 | Seed |
| T-0119 | v2-Präfix, 317 Dateien | 493.721.393 | Seed |
| T-0120, T-0124 | v4, 1.563 Dateien | 2.501.801.023 | Seed |
| T-0127, T-0131 | v4 und Δ5 mit 384 Dateien | 3.131.080.541 | Seed |
| T-0135 | v4, Δ5 und Δ6 mit 1.082 Dateien | 4.934.592.622 | Seed |
| T-0144 | v7j, 2.464 Dateien | 4.100.869.336 | Seed |
| T-0168 | v8j, 3.348 Dateien | 5.575.059.348 | Seed, über einen eigenen Vorlauf |
| T-0180 | Stellungen aus dem v8-Delta, neu etikettiert | 151.999.515 | T-0168 |
| T-0189 | v10-Stellungen, neu etikettiert | 148.834.647 | Zwischennetz |
| Zwischennetz | v10, 8.197 Dateien nach dem Prüfmengenfilter | 13.591.787.474 | Seed |
Datenzeilen sind Datensatzgrößen einschließlich des Validierungsteils. Das Zwischennetz ist das eigene Netz des Projekts, mit dem T-0189 begann; es lag selbst nicht auf dem Hauptzweig. Kein Netz des Hauptzweigs hat einen fremden Gewichtsvorfahren.
Was geprüft wurde
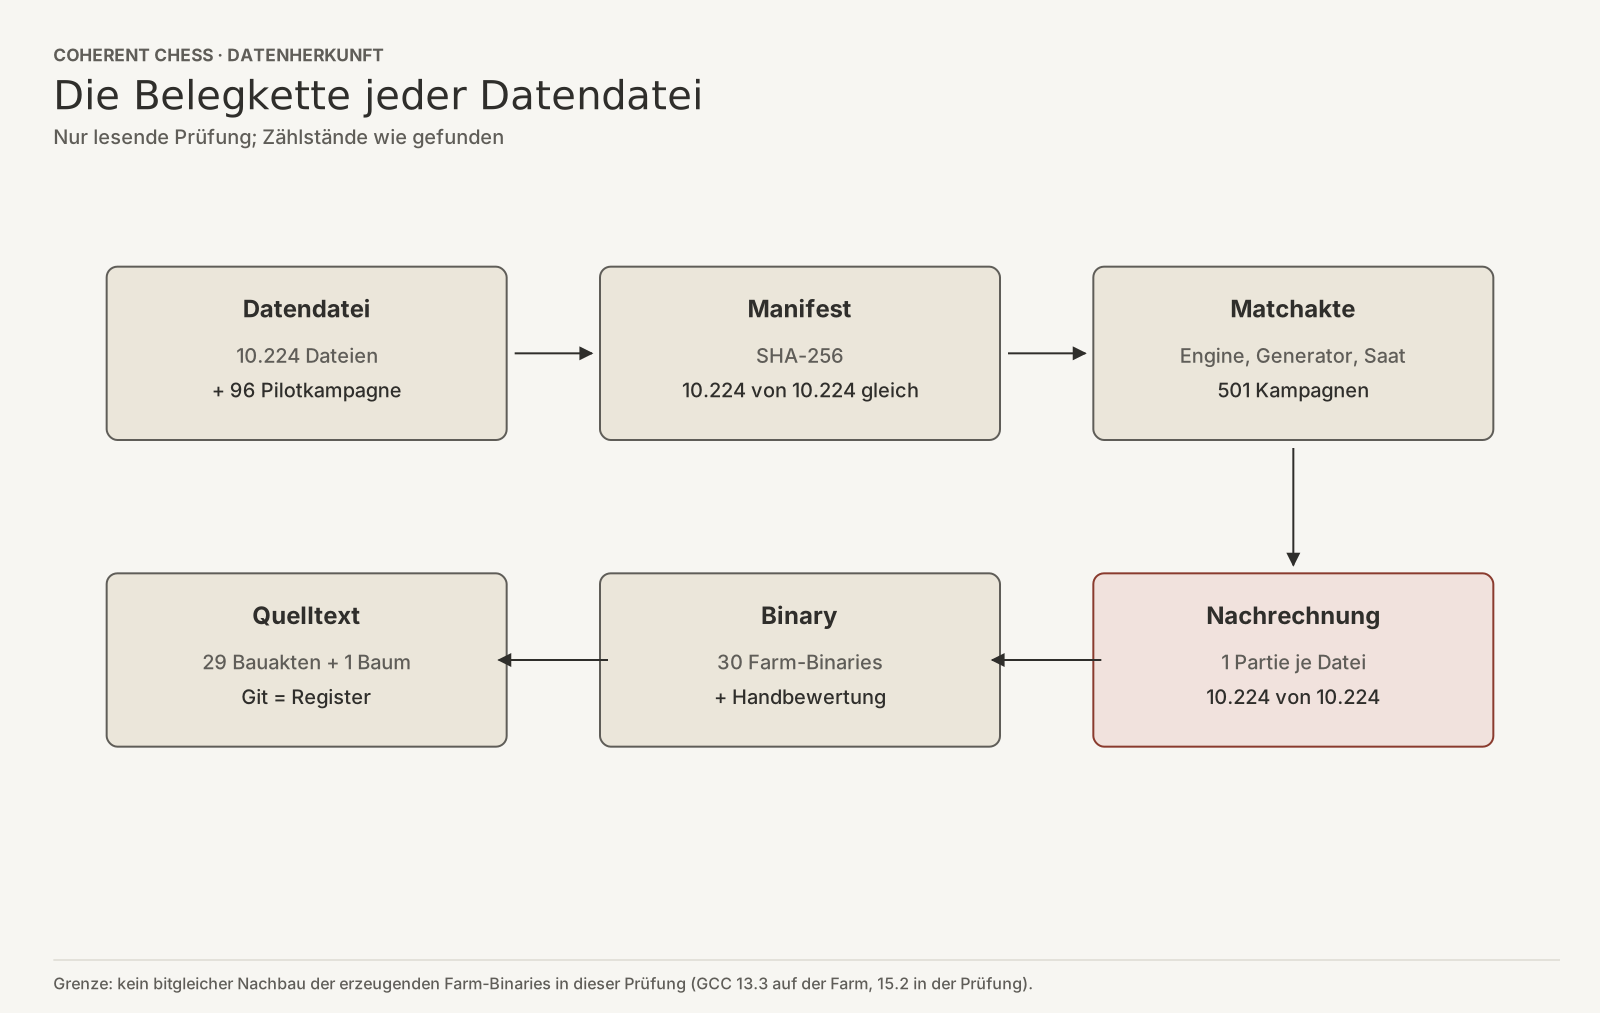
- Dateien: Alle 10.224 Originaldateien der Datensätze von T-0085 bis T-0189, 10.223 Shards mit 301,6 GB und 1 Replay-Datei, sind bytegleich mit ihren Manifest-Hashes, ebenso die 96 Dateien der Pilotkampagne. Jede Datei zählt einmal, auch wenn mehrere Netze sie nutzen.
- Erzeugungsakten: Zu jeder Datei gibt es eine abgeschlossene Matchakte mit Engine-Binary, Generatorversion, Saat und Partiebereich. Es sind 501 Kampagnen; keine mischt Binaries. Alle 31 Erzeuger sind eigene Engines: 30 Farm-Binaries und die handgeschriebene Bewertung.
- Nachrechnung: Aus jeder der 10.224 Dateien wurde eine zufällig gezogene Partie mit Binary und Generator ihrer Akte neu ausgespielt: 10.224 von 10.224 bitgleich, mit 1.196.488 Datenzeilen aus allen 30 Farm-Binaries. Dasselbe gilt für 96 von 96 Dateien der Pilotkampagne.
- Stichprobe: Die vorab festgelegte geschichtete Stichprobe nach der Verfassung ergab 505 von 505 Partien bitgleich, mit 58.418 Datenzeilen in 11 Schichten. Ein unabhängiger Prüfer mit eigener Saat kam auf 22 von 22. Ohne Abweichung liegt die einseitige 95-Prozent-Obergrenze für die Abweichungswahrscheinlichkeit je Ziehung, nach dem jeweiligen Ziehungsverfahren, bei 5,8 Prozent für eine Schicht mit 50 Ziehungen und bei 45 Prozent für die Replay-Datei mit 5 Ziehungen.
- Bitgleich heißt: Byte für Byte dieselben Zeilen bei fester Saat und fester Knotenzahl. Die Nachrechnung zeigt, dass die Partien mit dem aktenkundigen Binary und Generator reproduzierbar sind; dass sie damals so erzeugt wurden, dokumentieren die Matchakten.
- Eröffnungen: Alle Generatoren spielen 8 zufällige legale Halbzüge aus der Grundstellung, gesteuert von einer Saat, und verwerfen, was die eigene Suche außerhalb von ±300 Centibauern sieht. Kein Generator liest ein Eröffnungsbuch.
- Endspieltafeln: Kein Erzeuger und kein Etikettierer hatte eine Tafeloption, und in keinem der 31 Erzeuger-Binaries kommt das Wort „syzygy“ vor. Tafeln konnten in kein Etikett eingehen.
- Lichess: Lichess-Daten wurden nur in Forschungsnetzen genutzt. Keines davon kam auf den Hauptzweig, keines ist Startnetz eines Netzes des Hauptzweigs, und keines erzeugte Daten für eines.
Ergänzungen zum früheren Beitrag
- Die Lehrer sind jetzt für jedes Netz belegt. Die erste Generation lernte von der handgeschriebenen Bewertung bei 5.000 Knoten. Die Selbstspieldaten aller späteren Netze stammen von der handgeschriebenen Bewertung oder von Engines mit früheren Netzen des Hauptzweigs; die spielenden Engine-Fassungen von v7j, v8j und v10 sind 8, 13 und 23 Binaries. Kein Netz lernte aus dem Selbstspiel seiner eigenen Engine.
- T-0180 und T-0189 sind gewollte Feinabstimmungen durch Selbstdestillation: Die Engine mit dem jeweiligen Startnetz etikettierte die Stellungen bei 20.000 Knoten neu, bei T-0189 die Engine mit dem eigenen Zwischennetz. Von den Etiketten von T-0189 sind 50 von 50 bitgleich nachgerechnet.
- Die „rund 150 Mio. Trainingszeilen“ von T-0180 sind 149.999.520 Trainingszeilen von 151.999.515.
- Die „rund 5,56 Mio. Trainingszeilen“ von T-0072 stimmen: 5.562.922 von 6.946.527 Stellungen. Alle 6.946.527 Zeilen des Altsatzes stehen wörtlich in den 96 Dateien der Pilotkampagne; der Altsatz von T-0076 ist dieselbe Menge.
- Die offene Zählweise der Kampagne 1 ist geklärt: 226.723.955 ist die nachgezählte Zeilensumme ihrer 147 Dateien, die 181.346.139 Trainingszeilen sind ihr Trainingsteil, und die Commits zu T-0099 und T-0100 nannten die Gesamtzahl „Trainingszeilen“. Die „rund 395 Mio. Lernzeilen“ von T-0119 sind 80 Prozent von 493.721.393 Datenzeilen.
Vor dem ersten Netz des Hauptzweigs
Das Netz von T-0072 ist die Generation 3 eines GPU-Piloten vom 2026-09-07, neu trainiert ohne Warmstart auf 96.000 Selbstspielpartien der handgeschriebenen Bewertung bei 5.000 Knoten. Davor lagen eine CPU-Stufe mit zwei CPU-Netzen und weiteren Forschungsnetzen sowie die Generationen 1 und 2. Keines davon lag auf dem Hauptzweig, und keines ist Gewichtsvorfahr der Generation 3. Die Reihe vor T-0072 ist Methodik, keine Vererbung. Der ganzzahlige Bewertungskern übernahm von ihnen keine Gewichte.
Toleranzen
- Inventurklausel: Nach der Verfassung gelten Netze, die am 2026-10-05 vorlagen, nach hashgebundener Inventur als geklärt. Die Inventur vom 2026-10-06 erfasst T-0072 bis T-0168. Gebraucht wird sie nur an 2 Stellen: für den Leseweg der Streaming-Läufe T-0119 bis T-0168, deren Dateiliste nur über die Zeilensumme an den Lauf gebunden ist, und für 11.763 und 16.418 Zeilen in v7j und v8j, deren Stellungen auch in später angelegten Prüfbüchern stehen. Diese Zeilen sind eigenes Selbstspiel; die Frage ist nicht ihre Herkunft, sondern ob die Messung unabhängig bleibt. Für die Daten von T-0072 bis T-0135 sind solche Überschneidungen nicht ausgezählt.
- Toleranz 10⁻⁵: Über sein Startnetz erbt T-0189 1 Zeile, die auch in einem später angelegten Uhrbuch steht, 1 von 120.000 Buchstellungen, also unter 10⁻⁵. Die Zeile kommt einmal vor, das Buch entstand nach dem Filter, und das gesamte Buch misst diese Linie nie. Alle Bedingungen der Verfassung sind erfüllt.
- Offengelegt, aber kein Toleranzfall: v10 enthält 1 Stellung, die auch in einem Tuningbuch steht (1 von 42.000). Nach einem Entscheid vom 2026-10-15 ist ein Tuningbuch keine Prüfmenge im Sinne der Verfassung; das Buch wird nicht benutzt. Die Prüfer sind uneins, ob es sperren sollte. Die Stellung selbst stammt aus eigenem Selbstspiel.
Grenzen
- Ein bitgleicher Nachbau der erzeugenden Farm-Binaries gelang in dieser Prüfung nicht: Die Farm baute mit GCC 13.3, auf dem Prüfrechner läuft GCC 15.2, und ein dokumentierter Nachbau ergab einen anderen Hash. Die Bindung vom Binary zum Quelltext beruht deshalb auf Bauakten: Jede Quelldatei von 29 Bauten ist bytegleich mit Git. Für das Binary der Kampagne 1 gibt es nur die Bindung über den registrierten Quellbaum. Die Nachrechnung zeigt, dass die Binaries die Daten erzeugen; ob ihr Code eigen ist, ist eine Frage des Engine-Codes, nicht der Daten.
- Leseweg des Trainers: Gezeigt ist, was in den Datensätzen steht, nicht Byte für Byte, was der Trainer las. Das deckt die Inventurklausel.
- Die Etiketten von T-0180 wurden in dieser Prüfung nicht nachgerechnet. Eine frühere Prüfung belegt sie mit 1.000 bitgleichen Zeilen, im zweiten Anlauf und unter geänderter Segmentregel. Geprüft sind die Stellungen: 50 von 50 stammen aus eigenen Kampagnen.
- Woher die Zahlen in der ersten handgeschriebenen Bewertung stammen, war nicht Teil dieser Prüfung. Sie ist die Engine, deren Suche die ersten Etiketten schrieb.
- Spätere Daten, die zu keinem Netz des Hauptzweigs gehören, sind nicht geprüft.
- Von den gefilterten v10-Dateien ist nur eine Stichprobe geprüft: 200 von 8.104. Alle 200 entstanden nur durch Entfernen von Zeilen aus dem Original, mit erhaltener Reihenfolge und dem Hash aus dem Manifest; die einseitige 95-Prozent-Obergrenze für nicht so abgeleitete Dateien liegt bei rund 1,5 Prozent.
Wie das geprüft wurde
Alle Primärdaten wurden nur gelesen. Die Prüfung verfolgte jede Datei von der Datei zum Manifest, zur Matchakte und zum Binary und vom Binary zur Bauakte, zum Git-Commit und zum Register, bei 1 Binary nur über den registrierten Quellbaum; die Hashes aller Shards rechnete sie neu. Jede gezogene Partie wurde mit dem Original-Generator und dem Original-Binary neu ausgespielt und Byte für Byte verglichen. Die Saaten standen vor der Rechnung fest. In der geschichteten Stichprobe wurden Farm-Dateien nach Zeilen gewichtet gezogen, Dateien der Pilotkampagne nach komprimierter Größe; in der zweiten Welle wurde aus jeder Datei eine Partie gezogen. Die Prüfung enthält keine Stellungen. Agenten zweier anderer Modellfamilien prüften sie gegen: einer mit Werkzeugen rechnete eigene Stichproben und den Vollhash nach, der andere ohne Werkzeuge prüfte die Aussagen gegen die Rohzähler. Keiner fand Hinweise auf fremde Daten; ihre Einwände gegen zu starke Formulierungen sind eingearbeitet. Ein Agent einer anderen Modellfamilie prüfte diesen Text gegen die Prüfung.