Läufe T-0203 bis T-0214: 11 Änderungen, keine übernommen
Diesen Beitrag anhören24 Min.
Von KI aus dem Text dieses Beitrags erstellt und von der synthetischen Stimme „Sulafat“ gelesen; keine wörtliche Fassung, Fehler sind möglich.
Wird geladen …
Von KI aus dem Text dieses Beitrags erstellt und von der synthetischen Stimme „Sulafat“ gelesen; keine wörtliche Fassung, Fehler sind möglich.Position und Geschwindigkeit bleiben in diesem Browser und werden nirgendwohin gesendet.
Die Aufnahme konnte nicht abgespielt werden. Audiodatei öffnen
Am 24. und 25.10.2026 hat das Orakel die Läufe T-0203 bis T-0214 in sein Register geschrieben. T-0205 wurde unterbrochen, seine Änderung kam als T-0206 erneut ins Orakel. Die 11 übrigen Läufe prüften je eine Änderung an der Suche der Engine gegen denselben Vorgänger, Coherent 0.2.24, und keine wurde übernommen: 10 scheiterten in der kurzen Stufe, T-0213 bestand sie und scheiterte in der langen. Zusammen spielte das Orakel dafür 292.132 Partien; die kurzen Stufen allein dauerten 36,6 Stunden.
Dieser Beitrag entstand im Auftrag des Betreibers. Er erklärt Punkt für Punkt, was jede Änderung tat und warum das Orakel sie ablehnte. Die Zahlen stammen aus dem Orakelregister, Export vom 25.10.2026. Jede Stufe wurde aus den Rohzählungen nachgerechnet, die Mathematik zusätzlich von 2 unabhängigen Prüfern.
Wie das Orakel entscheidet
Die neue Fassung spielt gegen den Vorgänger in Paaren: 2 Partien mit derselben Eröffnung und getauschten Farben. Ein Paar bringt ihr 0, 0,5, 1, 1,5 oder 2 Punkte. Das Register zählt, wie oft jede dieser 5 Klassen vorkam; das ist das Pentanomial Gespielt wird in Paaren mit vertauschten Farben; die fünf Zahlen sind die Paare mit 0, ½, 1, 1½ und 2 Punkten.. Teilt man die Punkte jedes Paars durch 2, sind μ und σ Mittelwert und Standardabweichung dieser Paaranteile.
- Elo Stärkeabstand zum Gegner, aus den Partien geschätzt, mit 95-Prozent-Halbbreite, wo das Orakel eine berichtet hat. Nie eine absolute Wertung.
= −400 · log10(1/μ − 1), die gewohnte Skala. - nElo Normiertes Elo: der Elo-Abstand geteilt durch die Streuung der Partieergebnisse, damit die SPRT-Schranken bei verschiedenen Bedenkzeiten dasselbe bedeuten.
= (μ − 0,5)/σ · 800/(√2 · ln 10). Das ist der Effekt in Einheiten der Paarstreuung; er bestimmt, wie viele Partien ein Test braucht. - Kurze Stufe: ein sequenzieller Test (SPRT Sequentieller Wahrscheinlichkeitsquotiententest. Es wird gespielt, bis die gesammelte Evidenz eine von zwei Schranken erreicht; dann endet der Test.) zwischen H0,
0nElo, und H1,+5nElo, mitα = β = 0,05. Nach jedem Paar wird das Log-Likelihood-Verhältnis LLR Log-Likelihood-Verhältnis, die laufende Evidenz eines SPRT. Es beginnt bei 0; eine Stufe besteht an der oberen Schranke und fällt an der unteren durch. fortgeschrieben. Der Lauf besteht, sobald esln 19 = 2,944erreicht, und wird abgelehnt, sobald es auf−2,944fällt. Nach höchstens96.000Partien endet er; ohne Entscheidung gilt er als unentschieden und besteht nicht. - Lange Stufe: eine Holdout-Stufe mit eigenen Bedingungen, die nicht veröffentlicht werden. Sie prüft dieselben Hypothesen mit
α = 0,05undβ = 0,25; ihre Schranken sindln 15 = 2,708undln(0,25/0,95) = −1,335. Ein Lauf besteht nur, wenn er beide Stufen besteht.
Das Orakel rechnet das LLR genau, nach dem Modell „normalized“ des Programms fastchess. Zum Verständnis reicht eine Näherung; mit ungerundetem nElo gerechnet weicht sie bei allen 12 Stufen dieses Beitrags um weniger als 0,01 vom Register ab:
LLR ≈ N · (nElo − 2,5) / 12.071, mit N Paaren und 12.071 ≈ (800/ln 10)² / 10.
2,5 nElo ist die Mitte zwischen H0 und H1. Daraus folgt eine einfache Regel: Die kurze Stufe lehnt ab, sobald der Schätzwert um 71.086 / Partien unter 2,5 nElo liegt. Nach 10.000 Partien heißt das unter −4,61 nElo, nach 50.000 Partien unter +1,08 nElo. Je näher der Schätzwert an der Mitte liegt, desto länger dauert der Lauf.
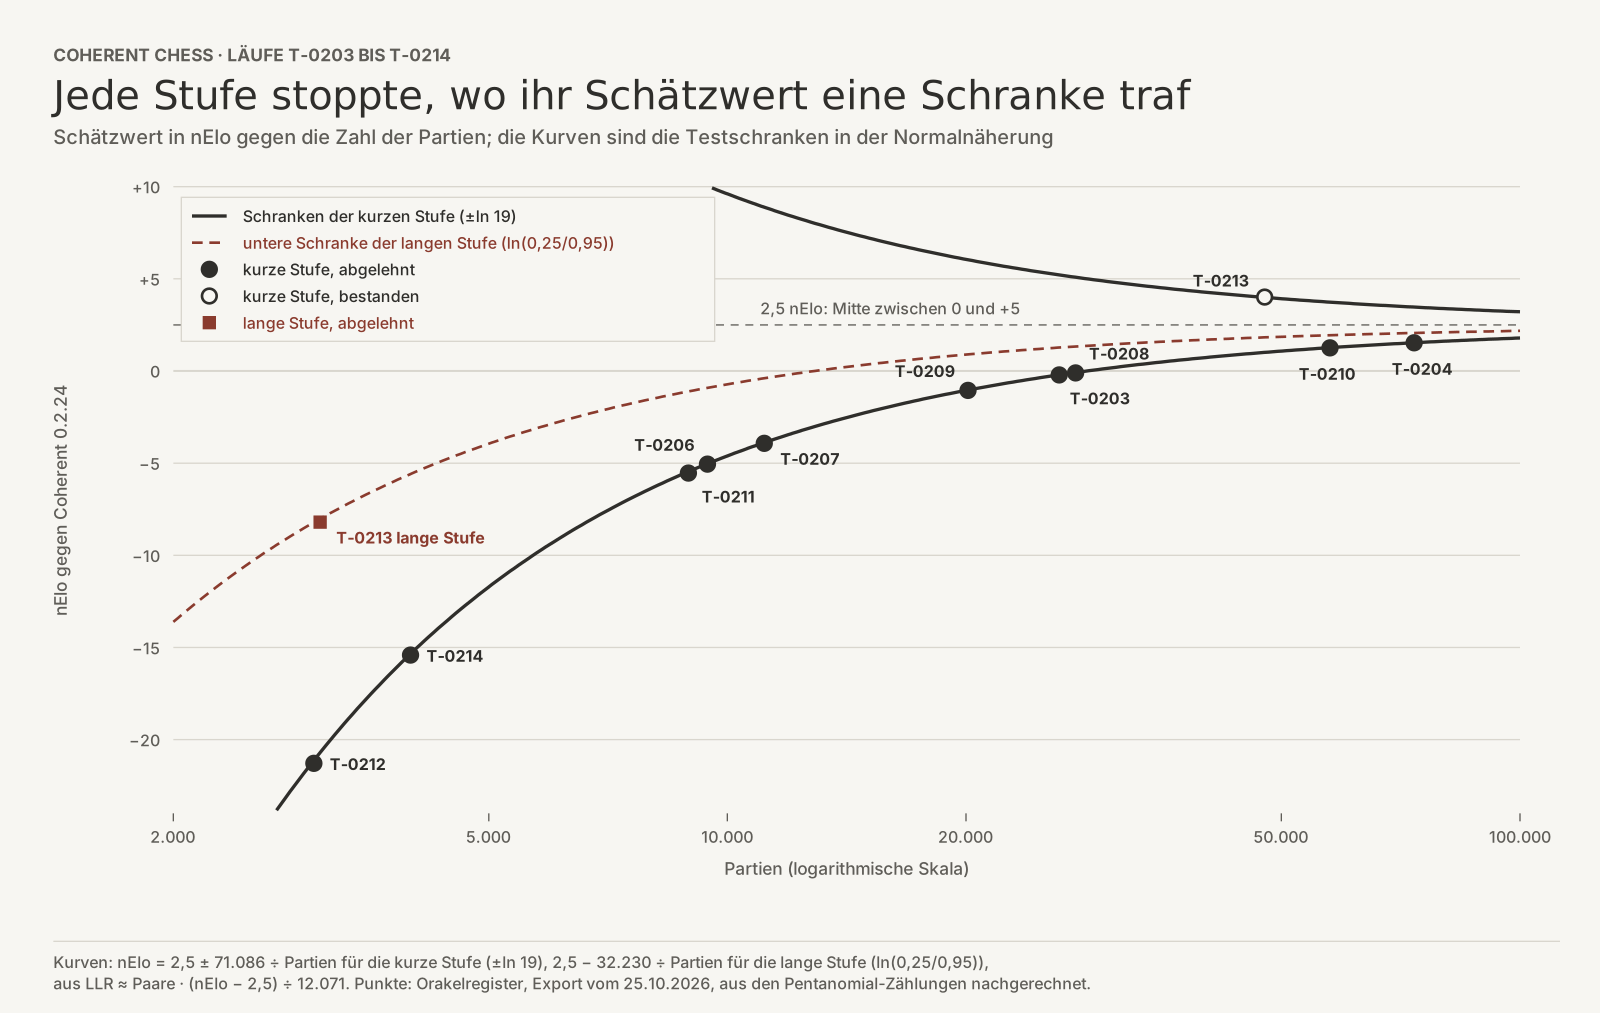
Das Bild zeigt jede abgeschlossene Stufe an der Stelle, an der sie stoppte: knapp jenseits der Schranke. Abgelehnt heißt: Das Verhältnis der Likelihoods von „0 nElo“ zu „+5 nElo“ hat 19 zu 1 erreicht, in der langen Stufe 3,8 zu 1. Es heißt nicht, dass die Änderung schadet. Ein Test, der an einer Schranke stoppt, liefert verzerrte Schätzwerte; ein früher Stopp überzeichnet den Abstand von der Mitte. Die Intervalle unten sind daher nominal.
Die Läufe im Überblick
| Lauf | Ansatzpunkt | Partien | Elo | nElo | LLR | Stunden | Urteil |
|---|---|---|---|---|---|---|---|
T-0203 | späte Zugreduktion | 26.224 | −0,11 ± 2,08 | −0,21 ± 4,21 | −2,95 | 3,3 | abgelehnt |
T-0204 | Tabellenschnitt | 73.526 | +0,75 ± 1,24 | +1,53 ± 2,51 | −2,97 | 9,2 | abgelehnt |
T-0205 | späte Zugreduktion | – | – | – | – | – | unterbrochen |
T-0206 | späte Zugreduktion | 9.440 | −2,54 ± 3,52 | −5,05 ± 7,01 | −2,95 | 1,2 | abgelehnt |
T-0207 | Lernen am Knotenende | 11.130 | −1,94 ± 3,18 | −3,92 ± 6,45 | −2,96 | 1,4 | abgelehnt |
T-0208 | Lernen am Knotenende | 27.502 | −0,05 ± 2,03 | −0,10 ± 4,11 | −2,96 | 3,5 | abgelehnt |
T-0209 | Schnitte je Zug | 20.120 | −0,52 ± 2,37 | −1,05 ± 4,80 | −2,96 | 2,5 | abgelehnt |
T-0210 | Lernen am Knotenende | 57.582 | +0,62 ± 1,40 | +1,26 ± 2,84 | −2,96 | 7,5 | abgelehnt |
T-0211 | Nullzug-Probe | 8.930 | −2,72 ± 3,54 | −5,54 ± 7,21 | −2,97 | 1,1 | abgelehnt |
T-0212 | Zugordnung | 3.008 | −10,51 ± 6,14 | −21,29 ± 12,42 | −2,96 | 0,4 | abgelehnt |
T-0213 | Wurzelrunde, kurze Stufe | 47.622 | +1,66 ± 1,30 | +4,01 ± 3,12 | +2,97 | 6,0 | bestanden |
T-0213 | Wurzelrunde, lange Stufe | 3.064 | −3,29 ± 4,93 | −8,20 ± 12,30 | −1,36 | – | abgelehnt |
T-0214 | iterative Vertiefung | 3.984 | −7,59 ± 5,31 | −15,41 ± 10,79 | −2,95 | 0,5 | abgelehnt |
Elo und nElo mit der nominalen 95-%-Halbbreite, jeweils gegen Coherent 0.2.24. Stunden: Messzeit der kurzen Stufe.
Kein Intervall reicht bis +5 nElo außer der kurzen Stufe von T-0213; zwei liegen ganz unter null. Schätzwert mit nominaler 95-%-Halbbreite: T-0203 -0,21, T-0204 1,53, T-0206 -5,05, T-0207 -3,92, T-0208 -0,1, T-0209 -1,05, T-0210 1,26, T-0211 -5,54, T-0212 -21,29, T-0213 kurz 4,01, T-0213 lang -8,2, T-0214 -15,41.
Wo die Änderungen ansetzen
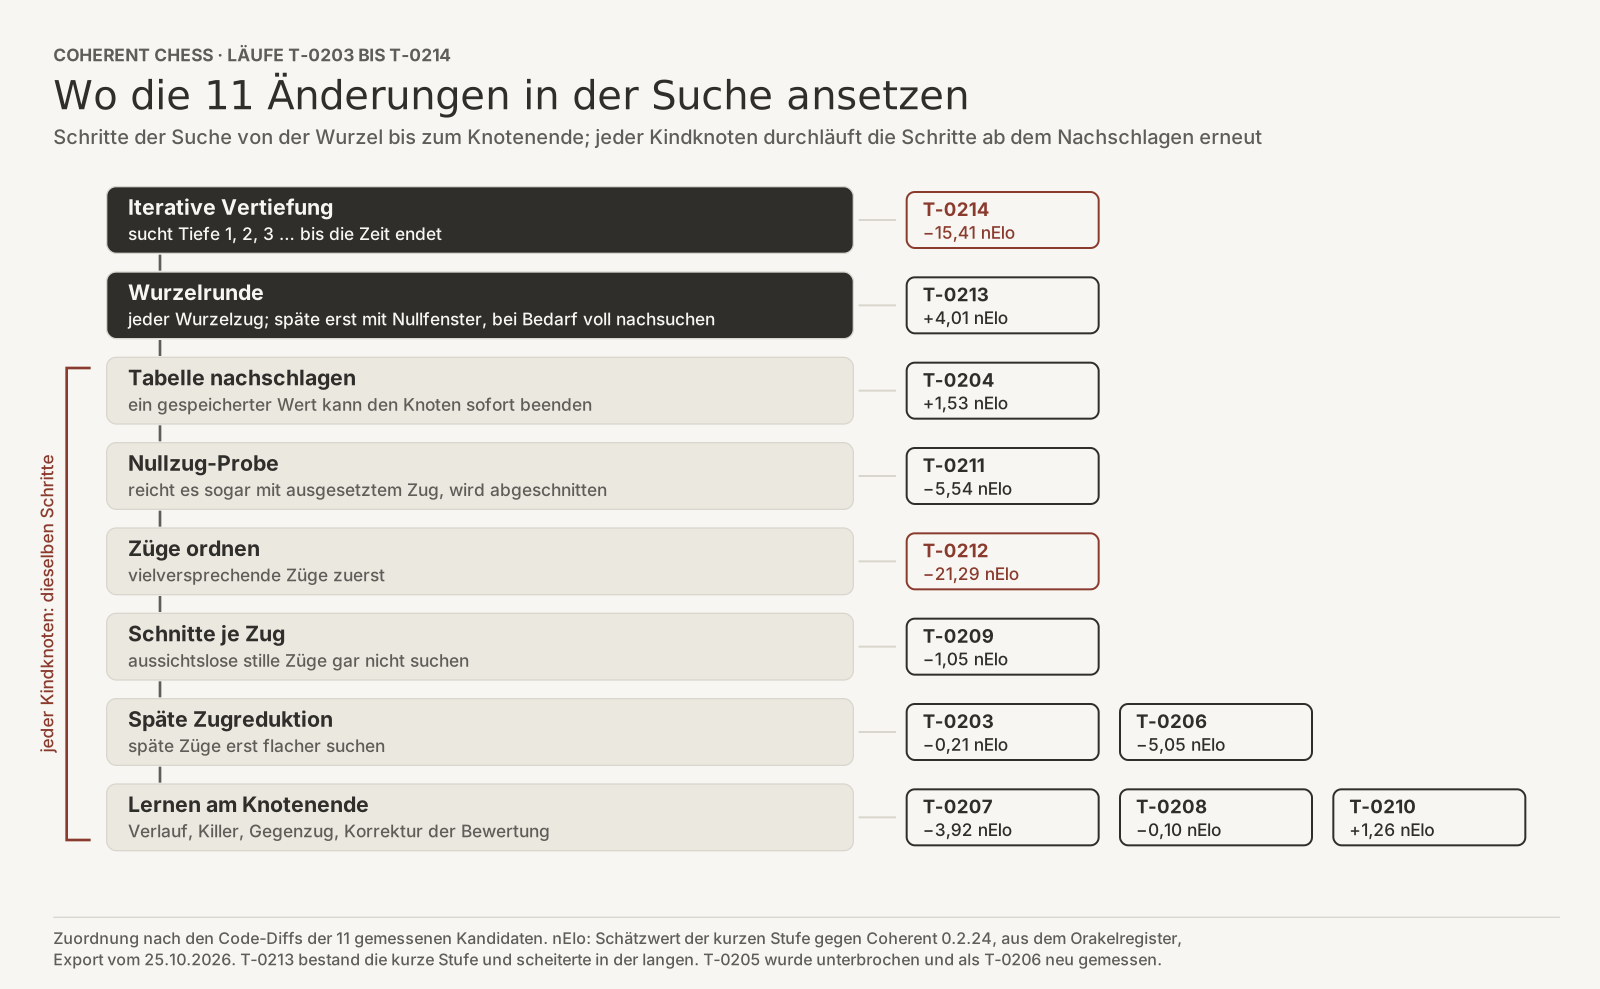
Die Suche probiert Züge in einem Baum aus. An der Wurzel steht die Stellung auf dem Brett. Die iterative Vertiefung sucht sie erst 1 Halbzug tief, dann 2, dann 3, bis die Zeit endet. In jedem Knoten des Baums laufen dieselben Schritte: Tabelle nachschlagen, Nullzug-Probe, Züge ordnen, je Zug schneiden oder reduzieren, am Ende lernen. Die 11 Änderungen verteilen sich über alle diese Schritte.
Punkt für Punkt
T-0203: Pendelzüge stärker reduzieren
Was getestet wurde. Die späte Zugreduktion sucht Züge, die in der Reihenfolge weit hinten stehen, zunächst flacher. Die Änderung reduzierte einen Zug um einen weiteren Halbzug, wenn er den Stein, den dieselbe Seite 2 Halbzüge zuvor gezogen hatte, auf dessen Ausgangsfeld zurückstellt, still und ohne Schach. Der Verlauf, nach dem die Suche Züge sonst einschätzt, kennt vom früheren Zug nur Stein und Zielfeld und unterscheidet dieses Pendeln nicht von einem Manöver auf dasselbe Feld. Die Stärke von 1 Halbzug war eine Wahl des Autors, nicht abgestimmt.
Warum abgelehnt. Nach 26.224 Partien lag der Schätzwert bei −0,21 nElo, 2,7 nElo unter der Mitte und genau auf der Schranke für diese Partiezahl; das LLR fiel auf −2,95. Das Intervall reicht von −4,42 bis +3,99: kein Gewinn und kein Verlust nachweisbar, +5 ausgeschlossen.
T-0204: Tabellenschnitt am gespeicherten Zug gegenprüfen
Was getestet wurde. Findet die Suche in der Tabelle einen ausreichend tiefen Eintrag mit einem Wert von mindestens Beta, beendet sie den Knoten sofort. Die Änderung prüfte vorher den Eintrag des Kindes nach dem gespeicherten Zug. Hatte das Kind einen Eintrag als Untergrenze oder genauen Wert, mindestens so tief wie die verlangte Suchtiefe minus 1, und besagte er, dass der Zug aus Sicht des Elternknotens unter Beta bleibt, entfiel der Schnitt, und der Knoten wurde normal gesucht. Das galt außerhalb der Hauptvariante und der Ausschlusssuche, einer Hilfssuche, die einen Zug ausschließt, für Werte ohne Matt und für einen legalen gespeicherten Zug. Das Risiko hatte der Autor benannt: Die Prüfung kostet Arbeit, und ein anderer Zug kann Beta trotzdem erreichen.
Warum abgelehnt. Der längste Lauf: 73.526 Partien in 9,2 Stunden. Der Schätzwert von +1,53 nElo lag positiv, aber unter der Mitte, und nach so vielen Partien lag die Schranke dort: LLR −2,97. Das Intervall von −0,99 bis +4,04 schließt einen kleinen Gewinn nicht aus, wohl aber +5. Für kleine Gewinne ist die kurze Stufe nicht gebaut: Eine Änderung mit wahren +1,5 nElo bestünde sie nach der Brownschen Näherung, ohne Partiegrenze, nur in etwa 24 % der Fälle.
T-0205: unterbrochen
Am 24.10. wurde der Rechner des Orakels während dieses Laufs aus- und wieder eingeschaltet. Das Register führt T-0205 als unterbrochen, ohne Stufenergebnisse und ohne Urteil. Dieselbe Änderung wurde danach als T-0206 gemessen.
T-0206: späte Zugreduktion an Knoten der Hauptvariante ab dem zweiten Zug
Was getestet wurde. Die Hauptvariante ist die Zugfolge, die die Suche gerade für die beste hält. An ihren Knoten waren bisher der erste und auch der zweite legale Zug von der späten Zugreduktion ausgenommen, an allen anderen Knoten nur der erste. Die Änderung hob die Ausnahme für den zweiten Zug auf; die Reduktion selbst wurde gleich berechnet. Im Code änderte sich 1 Bedingung.
Warum abgelehnt. Der Schätzwert lag deutlich unter null, darum reichten 9.440 Partien in 1,2 Stunden: −5,05 nElo, LLR −2,95. Das Intervall reicht von −12,06 bis +1,96.
T-0207: kein Ordnungslernen aus Remisergebnissen
Was getestet wurde. Am Ende eines Knotens lernt die Suche aus dem besten Zug, unter anderem Verlaufswerte, also Boni für ihn und Mali für die vorher gesuchten Züge, dazu Killerzüge und Gegenzug. Diese Werte ordnen später die Züge in anderen Stellungen. Die Änderung ließ dieses Lernen und auch das Lernen für den vorangegangenen Zug aus, wenn das Ergebnis des Knotens genau Remis war. Der Gedanke des Autors: Remisergebnisse, die vom Weg zur Stellung abhängen, sollen die Zugordnung anderswo weniger beeinflussen. Als Risiko nannte der Autor, dass dann auch brauchbare Verteidigungszüge nichts mehr lernen.
Warum abgelehnt. 11.130 Partien: −3,92 nElo, LLR −2,96. Das Intervall reicht von −10,38 bis +2,53.
T-0208: Verlaufsbonus nach Erreichungsquote
Was getestet wurde. Der Verlaufsbonus für einen besten Zug wuchs bisher außerhalb der Hauptvariante mit der Zahl der legalen Züge, die der Knoten bis dahin erreicht hatte, bis zu 8, auch solcher, die ohne Suche abgeschnitten wurden; an Knoten der Hauptvariante gab es diese Zulage nicht. Die Änderung ersetzte sie durch einen gezählten Faktor: An Knoten außerhalb der Hauptvariante zählt die Suche, wie oft sie den ersten, zweiten und so fort bis zum neunten Zug tatsächlich sucht. Je seltener Knoten so viele Züge suchen wie dieser, desto größer der Bonus, höchstens das 4-Fache und gedeckelt durch die vorhandenen Obergrenzen; an anderen Knoten bleibt der Faktor 1. Mali, Killer und Gegenzug blieben gleich.
Warum abgelehnt. 27.502 Partien: −0,10 nElo, LLR −2,96. Das Intervall reicht von −4,21 bis +4,00.
T-0209: Verlaufsschnitt entfernt
Was getestet wurde. Bei kleiner Resttiefe suchte die Engine stille Züge gar nicht erst, deren Verlaufswert unter einer negativen Schwelle lag, die mit der Tiefe weiter sinkt. Schachgebote und Drohzüge waren ausgenommen. Die Änderung entfernte diesen Schnitt samt seinen 2 Stellschrauben; alle anderen Schnitte blieben. Züge, die bisher allein wegen ihres schlechten Verlaufs wegfielen, wurden nun weitergesucht. Das Gegenrisiko hatte der Autor benannt: Die zusätzliche Suche kann in derselben Zeit bessere Arbeit verdrängen.
Warum abgelehnt. 20.120 Partien: −1,05 nElo, LLR −2,96. Das Intervall reicht von −5,85 bis +3,75.
T-0210: keine Bewertungskorrektur aus Remisergebnissen
Was getestet wurde. Am Knotenende lernt die Suche auch eine Korrektur ihrer statischen Bewertung. Die Einträge hängen an Bauern-, Figuren- und Zugschlüsseln, nicht am Weg zur Stellung. Remiswerte aus Zugwiederholung und Fünfzigzügeregel hängen aber am Weg; so konnte der Wert eines Weges die Korrektur für andere Wege verschieben. Die Änderung ließ dieses Lernen aus, wenn das Ergebnis genau Remis war. Die Grenze hatte der Autor benannt: Der Filter trifft auch echte Remisstellungen wie eine Festung, in denen der Remiswert die richtige Auskunft wäre.
Warum abgelehnt. Wie T-0204 lag der Schätzwert positiv, aber unter der Mitte: +1,26 nElo nach 57.582 Partien in 7,5 Stunden, LLR −2,96. Das Intervall reicht von −1,58 bis +4,10.
T-0211: Nullzug-Probe auch bei Untergrenze aus der Tabelle
Was getestet wurde. Bei der Nullzug-Probe setzt die Suche einen Zug aus und sucht flacher weiter. Erreicht das Ergebnis trotzdem mindestens Beta, wird der Knoten abgeschnitten, in großer Tiefe erst nach einer Prüfsuche. Bisher musste dafür auch die statische Bewertung mindestens Beta sein. Die Änderung ließ die Probe auch zu, wenn nur eine Untergrenze aus der Tabelle Beta erreichte und die statische Bewertung darunter lag, sofern nach der Reduktion mindestens 2 Halbzüge blieben. Mit den geltenden Werten betraf das Knoten ab Tiefe 9. Als Risiken nannte der Autor zu optimistische flache Tabellenwerte, Zugzwang und die Kosten erfolgloser Proben.
Warum abgelehnt. 8.930 Partien in 1,1 Stunden: −5,54 nElo, LLR −2,97. Das Intervall reicht von −12,75 bis +1,66.
T-0212: stille Züge im Rundlauf über die Ausgangsfelder
Was getestet wurde. Die Zugordnung reiht die stillen Züge nach einem Rangwert. Die Änderung ordnete den hinteren Teil an Knoten außerhalb der Hauptvariante und ohne Schach neu: je Runde von jedem Ausgangsfeld der beste noch übrige Zug, dann die nächste Runde. So sollten Züge verschiedener Steine früher an die Reihe kommen, bevor späte Züge abgeschnitten werden. Der vordere Teil der Liste mit Killern, Gegenzug, Flucht- und Schachzügen blieb unverändert. Das Gegenrisiko hatte der Autor benannt: Mehrere Züge desselben Steins können die besseren sein.
Warum abgelehnt. Der kürzeste Lauf: 3.008 Partien in 23 Minuten, −21,29 nElo, LLR −2,96. Hier liegt das ganze nominale Intervall unter null, von −33,70 bis −8,87. Der Betrag ist nach so frühem Stopp eher überzeichnet.
T-0213: Wert der Nullfensterprobe bei abgebrochener Nachsuche bewahren
Was getestet wurde. An der Wurzel prüft die Suche jeden späteren Zug zuerst mit einem Nullfenster: Ist er besser als der bisher beste? Sagt die Probe ja, wird er mit vollem Fenster nachgesucht, um seinen Wert zu bestimmen. Lief dabei die Zeit ab, zählte bisher nur, was vollständig gesucht war, und der Zug blieb unberücksichtigt, obwohl die Probe ihn schon über dem bisher besten sah. Die Änderung übernahm ihn in diesem Fall als besten Zug der Runde, mit dem Wert der Probe als Untergrenze. Voraussetzung war eine vollständige Probe auf voller Tiefe; den abgebrochenen Wert und die unvollständige Variante nutzte sie nicht.
Warum abgelehnt. Die kurze Stufe bestand: +4,01 nElo nach 47.622 Partien in 6,0 Stunden, LLR +2,97. Ihr Intervall von +0,89 bis +7,13 liegt ganz über null. Die lange Stufe lehnte nach 3.064 Partien ab: −8,20 nElo, LLR −1,36, knapp unter ihrer Schranke von −1,335. Ihr Intervall reicht von −20,50 bis +4,10 und überlappt das der kurzen Stufe. Die lange Stufe hat einen nominalen Fehler zweiter Art von β = 0,25: Eine Änderung mit wahren +5 nElo lehnt sie nach Auslegung in etwa einem Viertel der Fälle ab. Dafür braucht sie im Erwartungswert weniger Partien. Welche Messung näher an der Wahrheit liegt, sagen diese Partien nicht. Die Regel entscheidet: Ein Lauf muss beide Stufen bestehen.
T-0214: tiefer einsteigen, wenn die Partie der Vorhersage folgt
Was getestet wurde. Die iterative Vertiefung beginnt jede Suche bei Tiefe 1. Die Änderung merkte sich nach jeder Suche die ersten 2 Züge der ausgegebenen Hauptvariante, den eigenen Zug und die erwartete Antwort. Folgte die Partie genau dieser Vorhersage und fand sich in der Tabelle ein genauer Eintrag für die neue Stellung mit legalem Zug und einer Tiefe von mindestens 4, aber unter der Höchsttiefe der Suche, begann die nächste Suche gleich bei dieser Tiefe, mit einem Suchfenster um den gespeicherten Wert. Die übersprungenen flachen Iterationen wurden nicht ersetzt.
Warum abgelehnt. 3.984 Partien in 31 Minuten: −15,41 nElo, LLR −2,95. Wie bei T-0212 liegt das ganze nominale Intervall unter null, von −26,20 bis −4,63.
Die Bilanz
- Keine der
11Änderungen zeigte einen Gewinn, den das Orakel annehmen konnte. Bei allen11abgelehnten Stufen liegt die obere Grenze des nominalen Intervalls unter+5nElo, dem Gewinn, nach dem die Tests fragen; die höchste liegt bei+4,10. 2Änderungen haben die Engine nach dem nominalen Intervall geschwächt:T-0212undT-0214. Bei den übrigen8abgelehnten kurzen Stufen und der langen Stufe vonT-0213schließt das Intervall null ein.- Die Messzeit ging vor allem an Änderungen, deren Schätzwert nahe der Mitte lag:
T-0204undT-0210brauchten zusammen16,7der36,6Stunden der kurzen Stufen,46%.
Eine Ablehnung beweist nicht, dass eine Idee nichts taugt. Sie sagt, dass diese Umsetzung gegen diesen Vorgänger keinen Gewinn von +5 nElo gezeigt hat. Keine dieser Änderungen kam in die Engine.
Wie das geprüft wurde
- Quellen: Orakelregister, Export vom
25.10.2026, EinträgeT-0203bisT-0214; die Code-Änderungen der11Kandidaten mit den Beschreibungen ihrer Autoren; die Laufseiten auf dieser Website; zuT-0205das Störungsprotokoll des Projekts vom24.10. - Nachrechnung: Partien, Elo, nElo, Halbbreiten, LLR und Urteil jeder Stufe wurden aus dem Pentanomial nachgerechnet und stimmen mit dem Register überein. Das LLR wurde zweimal gerechnet, von den Agenten des Projekts mit einem eigenen genauen Löser und mit der Rechnung der Projektsteuerung, die fastchess nachbildet; beide stimmen auf
4Nachkommastellen überein. - Unabhängige Prüfung:
2Agenten aus2verschiedenen Modellfamilien rechneten jede Stufe getrennt und mit eigenem Code aus dem Pentanomial nach, jeweils mit einem anderen Lösungsverfahren für das LLR, und prüften jede Rechenaussage, die Beschreibungen gegen die Diffs und die Übereinstimmung der Sprachfassungen. Beide fanden keine falsche Zahl; ihre Hinweise auf ungenaue Formulierungen sind eingearbeitet. - Nicht geprüft: ob die Änderungen den Code so umsetzen, wie ihre Autoren es beschreiben, über das Lesen der Diffs hinaus.