Ein neues Startnetz: Version 0.2.19
Diesen Beitrag anhören8 Min.
Von KI aus dem Text dieses Beitrags erstellt und von der synthetischen Stimme „Sulafat“ gelesen; keine wörtliche Fassung, Fehler sind möglich.
Wird geladen …
Von KI aus dem Text dieses Beitrags erstellt und von der synthetischen Stimme „Sulafat“ gelesen; keine wörtliche Fassung, Fehler sind möglich.Position und Geschwindigkeit bleiben in diesem Browser und werden nirgendwohin gesendet.
Die Aufnahme konnte nicht abgespielt werden. Audiodatei öffnen
Am 2026-10-18 um 10:57 UTC bestand Version 0.2.19 den Orakellauf T-0189; um 10:59 UTC kam sie auf den Hauptzweig. Die Änderung tauscht nur das Bewertungsnetz. Wie beim Vorgänger stammen alle Trainingsdaten aus der eigenen Engine. Neu ist das Startnetz: Es wurde von Grund auf neu trainiert, auf 13.591.787.474 statt 5,58 Milliarden Zeilen eigenen Selbstspiels. Die Feinabstimmung per Selbstdestillation folgt dem Verfahren, das schon für den Vorgänger im Lauf T-0180 galt. Dieser Beitrag beschreibt Aufbau, Training, Prüfung und Messung. Er entstand im Auftrag des Betreibers. Die Orakel-Elo Stärkeabstand zum Gegner, aus den Partien geschätzt, mit 95-Prozent-Halbbreite, wo das Orakel eine berichtet hat. Nie eine absolute Wertung.-Werte messen die Leistung gegen den Vorgänger unter Orakelbedingungen; ein Vorabergebnis ist unten gesondert gekennzeichnet. Keiner dieser Werte ist eine externe Spielstärke.
Was sich ändert
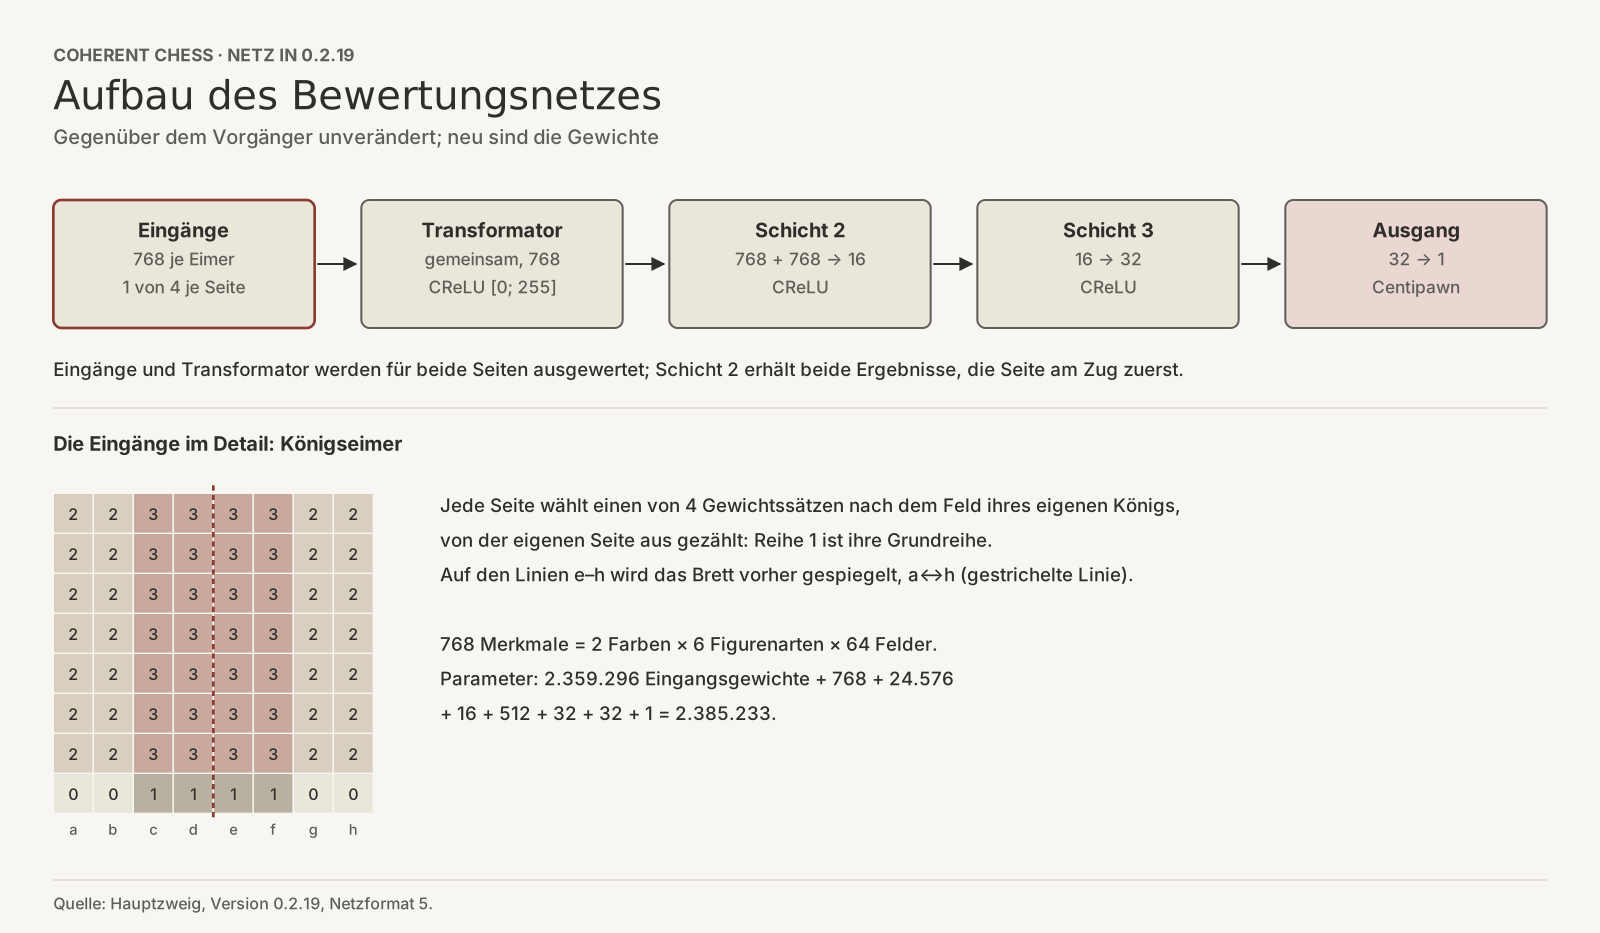
Die Änderung betrifft nur die Datei mit den Netzgewichten und die Versionsnummer. Der Aufbau ist derselbe wie beim Vorgänger.
- Eingänge: 768 Merkmale je Seite, 2 Farben mal 6 Figurenarten mal 64 Felder, seitenrelativ kodiert.
- Königseimer: Je nach Feld des eigenen Königs wählt das Netz einen von 4 Gewichtssätzen. Steht der König auf den Linien e bis h, wird das Brett vorher gespiegelt.
- Merkmalstransformator: 768 Werte je Seite in ganzzahliger Rechnung, begrenzt auf [0; 255] (CReLU). Beide Seiten zusammen ergeben 1.536 Werte, die Seite am Zug zuerst.
- Kopf: Schichten mit 16 und 32 Neuronen, beide CReLU, dann ein Ausgang in Centipawn.
Zusammen sind das 2.385.233 Parameter, davon 2.359.296 Eingangsgewichte. Neu sind alle Gewichte und die Ausgangsskalierung (154 statt 159).
Training in zwei Schritten
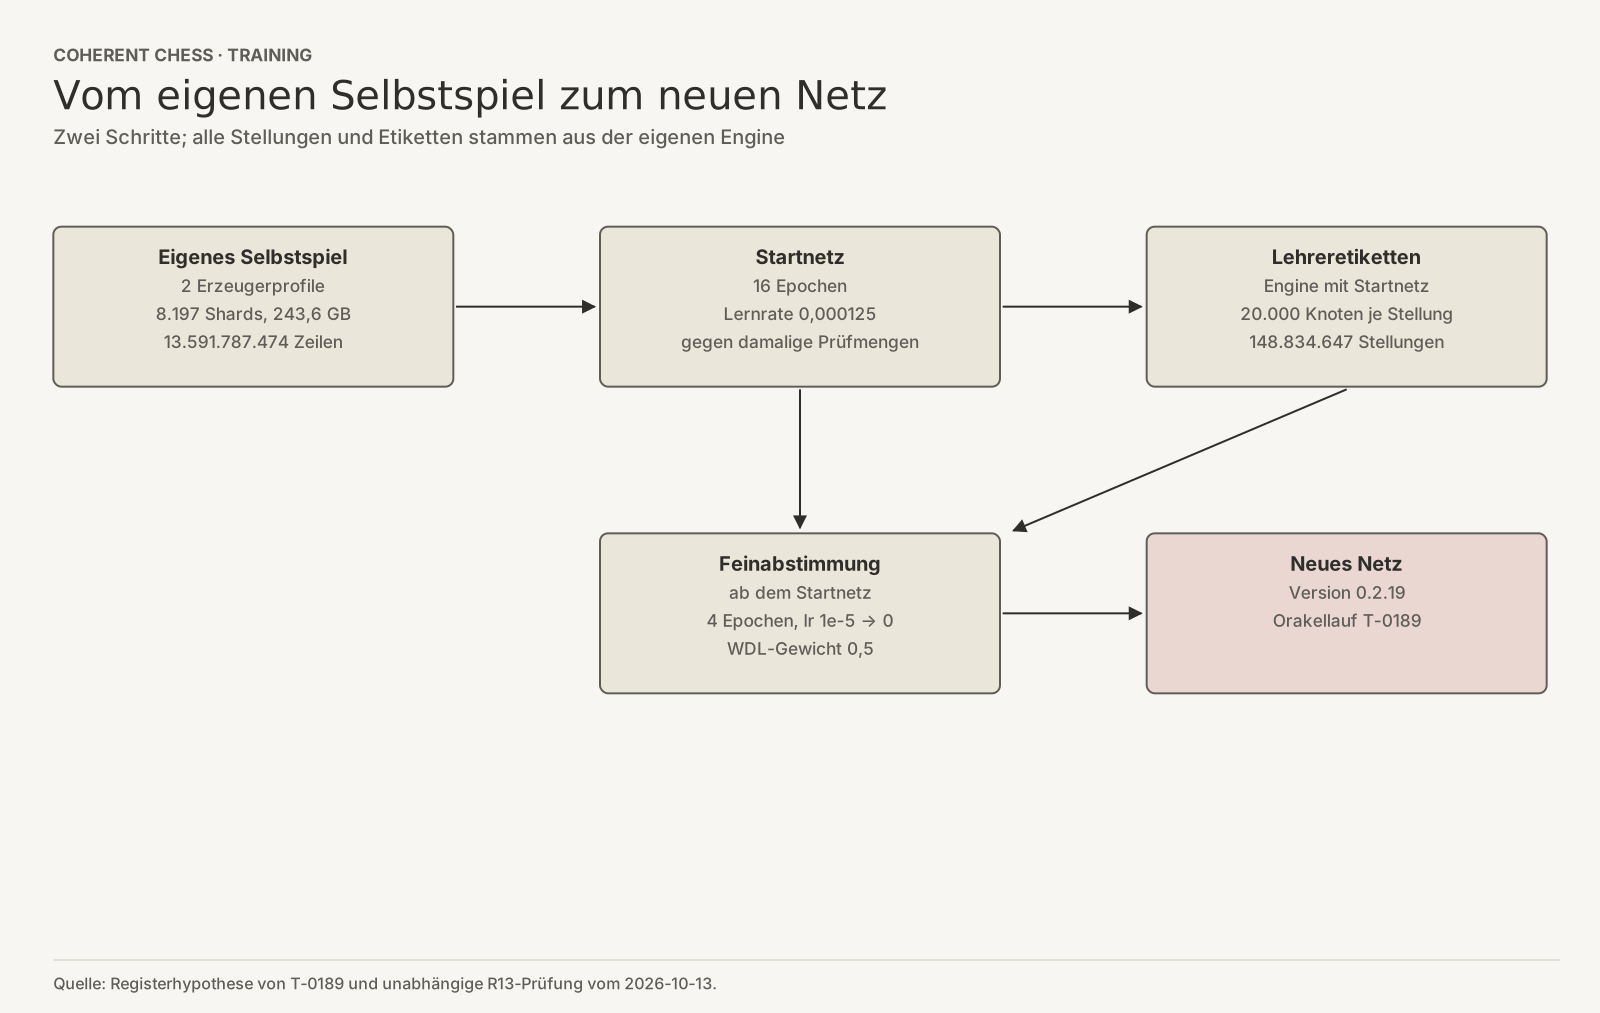
Im ersten Schritt entstand ein Startnetz aus eigenem Selbstspiel: 8.197 Datenpakete aus 2 Erzeugerprofilen, 243,6 GB, 13.591.787.474 Trainingszeilen. Die Daten wurden vorher gegen die damals vorhandenen Prüfmengen gefiltert, also gegen die Stellungen, mit denen das Projekt misst. Trainiert wurde 16 Epochen mit der Lernrate 0,000125.
Im zweiten Schritt rechnete die Engine mit diesem Startnetz 148.834.647 Stellungen aus demselben Selbstspiel mit je 20.000 Knoten nach. Diese Suchergebnisse wurden zu neuen Etiketten, und das Startnetz wurde darauf feinabgestimmt: 4 Epochen, die Lernrate fiel je Schritt von 1e-5 auf 0, das WDL-Gewicht lag bei 0,5. Das Netz lernt so von der Suche, die es selbst steuert; man nennt das Selbstdestillation. Vor dem Etikettieren wurden die Stellungen gegen 70 Prüfmengeninhalte gefiltert, mit 0 Treffern.
Prüfung vor der Messung
Die Verfassung des Projekts verlangt für jedes neue Netz eine unabhängige Prüfung von Herkunft und Daten. Sie bestand.
- Startgewichte, Trainingscode, Rezept, Saaten, Datenmanifest und Netzdatei wurden über ihre Hashes bestätigt.
- Der Prüfer zog vorab festgelegt 8 der 5.955 Etikettenteile und rechnete sie nach: 200.000 Zeilen, bitgleich, 0 Abweichungen.
- 200.000 von 200.000 Stichprobenzeilen fanden sich wörtlich in den eigenen Selbstspieldaten. Fremddaten: keine.
- In den Daten des Startnetzes fand eine Vollzählung 1 Zeile in 13.591.787.474, die zu einer später angelegten Prüfmenge gehört. Das erfüllte die Toleranzregel der Verfassung. Diese Prüfmenge darf das Netz nicht messen, und die Nachweise müssen erhalten bleiben.
Ein Vorabmatch gegen den Hauptzweig bei 8+0.08 Sekunden ergab über 4.000 Paare +17,39 Elo mit Standardfehler 1,54, einseitige untere 95-Prozent-Grenze +14,85. Das war ein Vortest unter anderen Bedingungen, kein Orakelergebnis.
Im Orakel
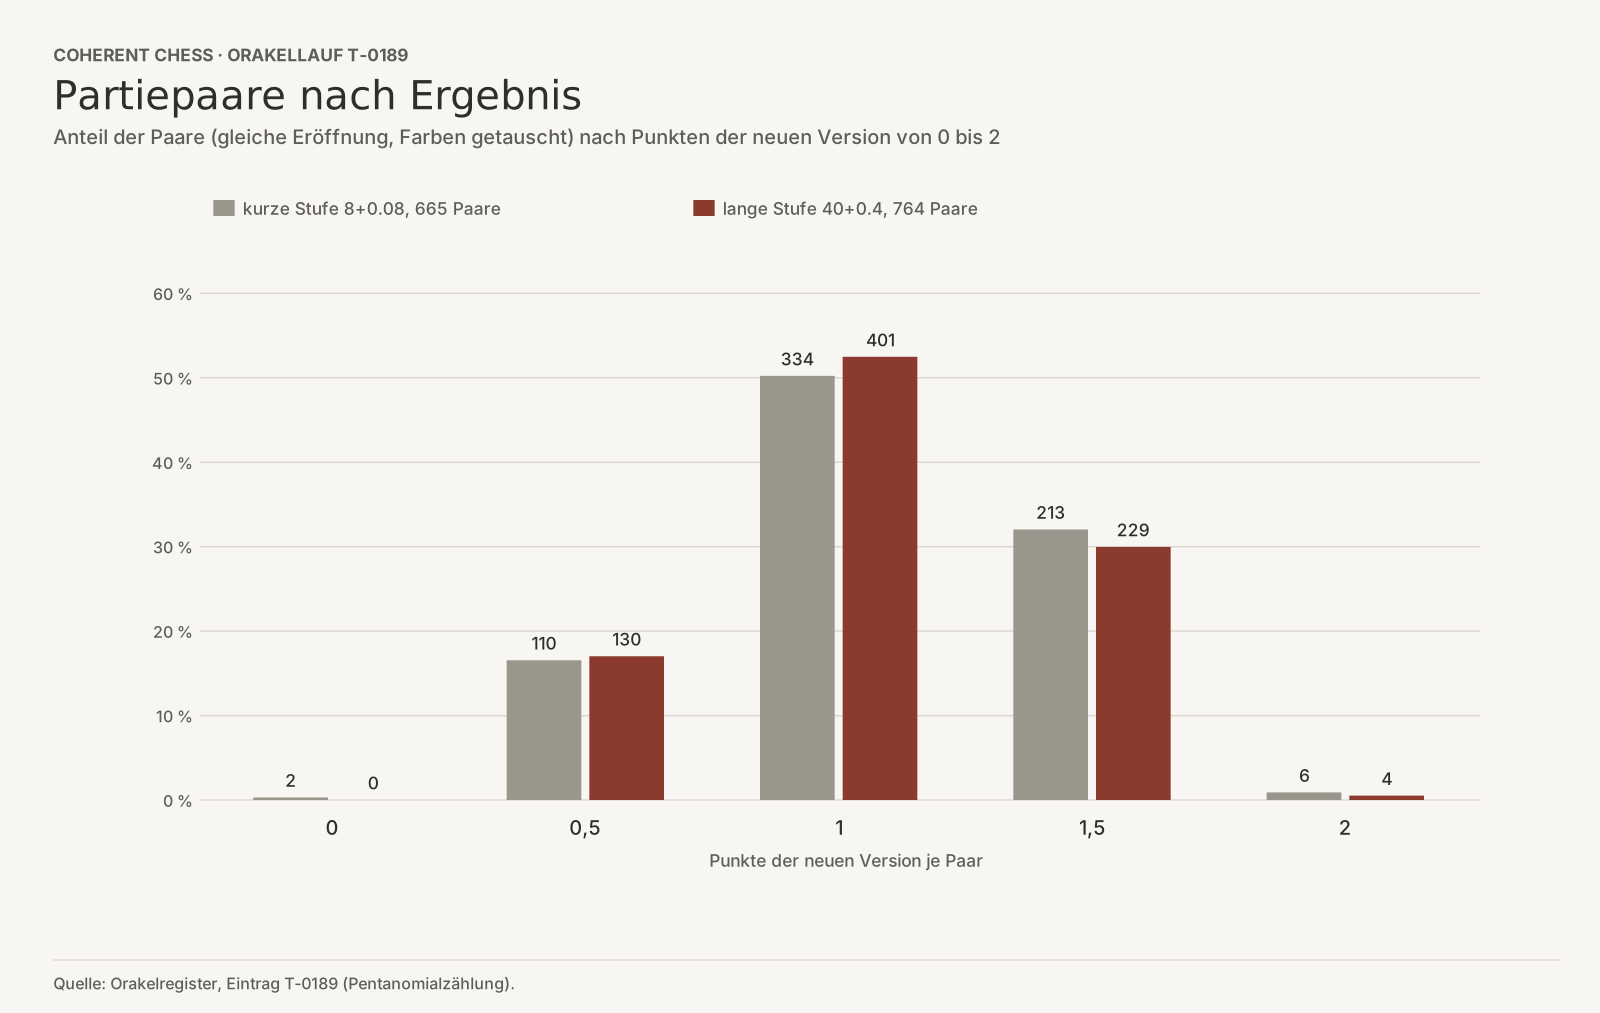
Das Orakel prüfte wie üblich in zwei sequenziellen Stufen gegen den Vorgänger 0.2.18, mit den Hypothesen 0 und 5 nElo Normiertes Elo: der Elo-Abstand geteilt durch die Streuung der Partieergebnisse, damit die SPRT-Schranken bei verschiedenen Bedenkzeiten dasselbe bedeuten. und Fehlerraten von je 0,05.
- Kurze Stufe, 8+0.08 Sekunden, Buch A: obere Schranke nach 1.330 Partien, 362 Siege, 251 Niederlagen, 717 Remis; +29,06 ± 9,46 Elo.
- Lange Stufe, 40+0.4 Sekunden, Buch B: obere Schranke nach 1.528 Partien, 392 Siege, 285 Niederlagen, 851 Remis; +24,37 ± 8,50 Elo.
Das sind bedingte logistische Elo-Schätzungen; ± nennt ein ungefähres 95-Prozent-Intervall aus der Endstichprobe, ohne garantierte Überdeckung bei sequenziellem Stoppen. Beide Stufen zusammen dauerten rund 71 Minuten. In der kurzen Stufe war das der größte geschätzte Gewinn seit T-0174 vom 2026-10-09. Da beide Stufen an der oberen Schranke endeten, können die Punktschätzungen nach oben verzerrt sein. Die Werte sind deshalb als Größenordnung zu lesen.
Was das zeigt und was nicht
Unter den Bedingungen des Orakels spielt 0.2.19 in beiden Bedenkzeiten deutlich stärker als 0.2.18. Wie viel davon auf das Startnetz und wie viel auf die Selbstdestillation entfällt, wurde im Orakel nicht getrennt gemessen. Die veröffentlichten Verankerungsdaten des Projekts enthalten keinen externen Wert für 0.2.19; die Elo-Werte hier sind nicht auf eine externe Skala übertragbar.
Wie das geprüft wurde
Die Fakten stammen aus dem Orakelregister, dem Code auf dem Hauptzweig, der Registerhypothese und den Akten der unabhängigen Netzprüfung. Für diesen Beitrag wurden die Parameterzahl aus den Feldgrößen im Code, die Pentanomialzählung gegen Siege, Niederlagen und Remis sowie der Vergleich mit früheren Läufen aus dem Register nachgerechnet. Ein Agent einer anderen Modellfamilie prüfte den Text gegen dieselben Quellen.