Epoche 13: zwei neue Wege durch das Orakel
Diesen Beitrag anhören18 Min.
Von KI aus dem Text dieses Beitrags erstellt und von der synthetischen Stimme „Sulafat“ gelesen; keine wörtliche Fassung, Fehler sind möglich.
Wird geladen …
Von KI aus dem Text dieses Beitrags erstellt und von der synthetischen Stimme „Sulafat“ gelesen; keine wörtliche Fassung, Fehler sind möglich.Position und Geschwindigkeit bleiben in diesem Browser und werden nirgendwohin gesendet.
Die Aufnahme konnte nicht abgespielt werden. Audiodatei öffnen
Am 31.10.2026 um 21:24 UTC nahm das Orakel wieder Tests an, die Instanz, die über jede Änderung an Coherent entscheidet. Seitdem gilt Epoche 13. Sie führt zwei Wege ein, die bisher nur in der Verfassung standen: Beschleunigungen bei gleichem Suchbaum und Spieleinstellungen. Beide können eine Änderung aufnehmen, ohne dass ein Spielstärkegewinn nachgewiesen wird. Der Weg für Gewinne und der Weg für Vereinfachungen bleiben, wie sie waren. Dieser Beitrag beschreibt, was die neuen Wege prüfen, warum die Temposchwelle bei 1,5 % liegt und wie der Wechsel in 3 Anläufen ablief. Er macht keine Aussage über Spielstärke. Die Epoche davor beschrieb der Beitrag „Epoche 12: ein Weg für Vereinfachungen“.
Was sich geändert hat
| Gewinnweg | Vereinfachung | Tempo, neu | Spieleinstellung, neu | |
|---|---|---|---|---|
| Was die Änderung zeigen muss | Gewinn | Nichtverschlechterung innerhalb der Marge | gleicher Suchbaum, messbar schneller, Nichtverschlechterung innerhalb der Marge | beim Standardwert nichts verändert, Tempoverlust in der Toleranz, vorhergesagte Wirkung |
| Test im Orakel | SPRT Sequentieller Wahrscheinlichkeitsquotiententest. Es wird gespielt, bis die gesammelte Evidenz eine von zwei Schranken erreicht oder das vorab festgelegte Partienlimit; dann endet der Test. 0 gegen +5 nElo Normiertes Elo: setzt den mittleren Punktüberschuss eines Farbtauschpaares ins Verhältnis zur Streuung der Paarergebnisse. | SPRT −3 gegen 0 nElo | SPRT −5 gegen 0 nElo | kein SPRT, Neutralitätsprüfung |
| Deckel je Stufe | 96.000 und 36.000 Partien | je 144.000 Partien | 96.000 und 36.000 Partien | – |
| Konto | keines | 4 Starts, höchstens 1 je Monat | 2 Starts, Abstand mindestens 24 Stunden | Toleranz 0,2 % je Option, 0,5 % zusammen |
| Zählt in Gesetz V mit | dem behaupteten Gewinn | Gewinn 0 | Gewinn 0 | Gewinn 0 |
Die Stufen des Gewinnwegs und die Konstanten des Vereinfachungswegs sind im Messcode von Epoche 12 und Epoche 13 wörtlich gleich. Neu ist der Fingerabdruck der Messumgebung, weiter in Fassung 3.
Der Tempoweg
Die Verfassung behandelt Tempo als Unterart des Randfalls: „Tempo bei gleichem Suchbaum wird als Unterart des Randfalls aufgenommen“. Das Urteil belegt laut Anhang A6 „Suchbaumgleichheit und Beschleunigung, keine Verlustfreiheit“.
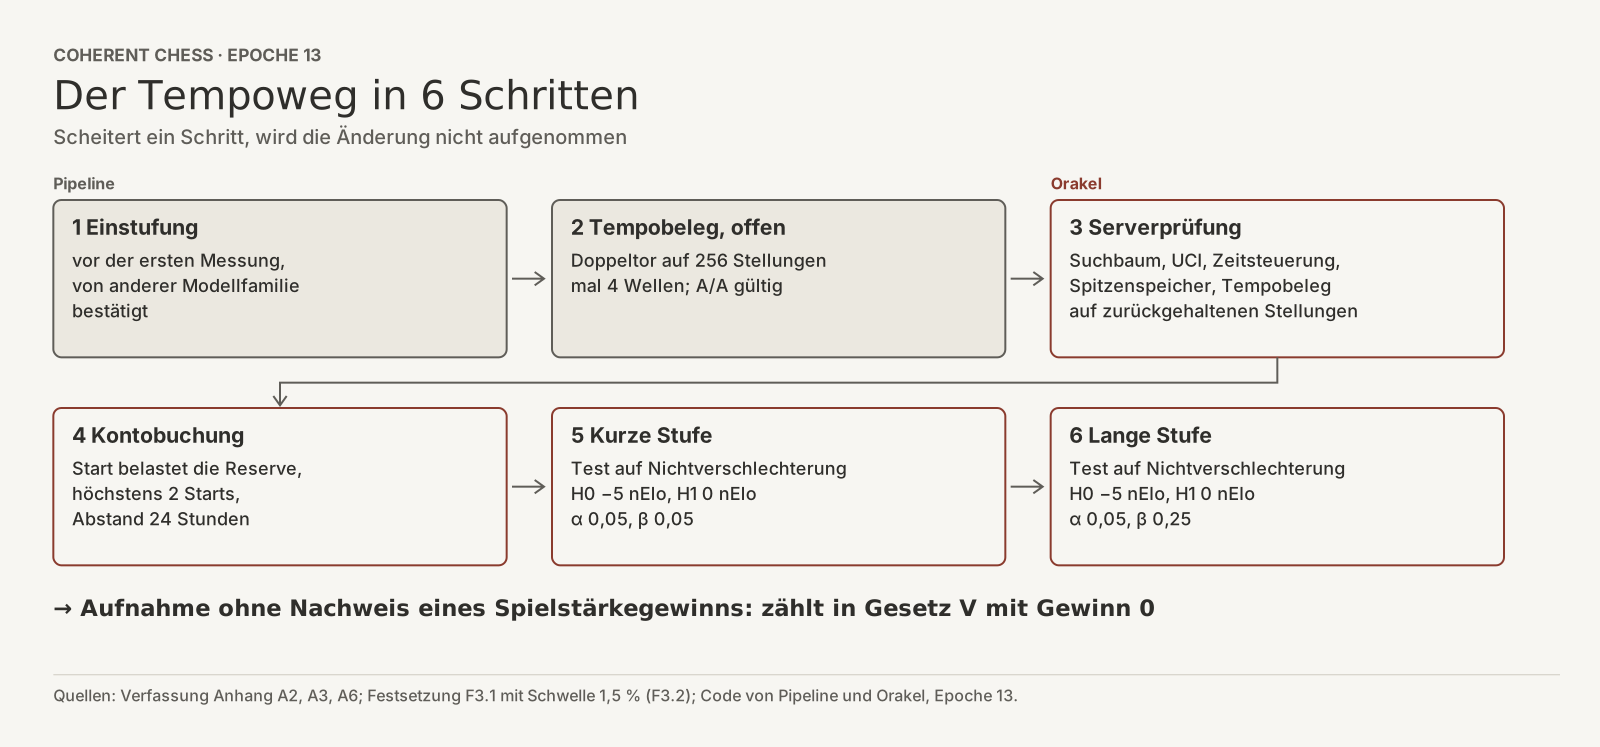
Zwei Größen entscheiden im Tempobeleg. Für jede Stellung wird die Zeit von Basis t_B und Kandidat t_K gepaart gemessen:
Geomittel  = 100 · (exp(Mittel von ln(t_B / t_K)) − 1)
Gesamtzeit = 100 · (Σ t_B / Σ t_K − 1)
Das Tor verlangt beides: Die untere Grenze des Geomittels muss über 1,5 % liegen, die untere Grenze der Gesamtzeit über 0. Die Grenzen stammen aus einem Bootstrap über die Stellungen mit 10.000 Wiederholungen; mit irrtum = 0,05 ist die untere Grenze das Quantil 2,5 %. Dazu kommt eine Gegenprobe: Die Basis misst gegen sich selbst, und dieses A/A-Band muss innerhalb von ±0,5 liegen und 0 enthalten. Das Doppeltor zielt auf den Fall, dass ein Kandidat viele kurze Stellungen schneller macht, während die Gesamtarbeit langsamer wird. In der Simulation der Festsetzung bestand ein solcher Kandidat nie.
Bei gleichem Suchbaum ist der Tempobeleg nur der erste Teil. Danach prüft das Orakel selbst: gleiche bench-Knotenzahl und keine Abweichung in Zug, Knoten und Bewertung, unveränderte UCI Universal Chess Interface, das Textprotokoll zwischen einer Schach-Engine und dem Programm, das sie steuert.-Schnittstelle und Zeitsteuerung, Spitzenspeicher höchstens 2.048 KiB über der Basis, und ein Tempobeleg auf zurückgehaltenen Stellungen. Erst dann folgt der Test auf Nichtverschlechterung in beiden Stufen.
Was das Konto begrenzt
Jeder Start belastet die Reserve von je 3 nElo vor dem Test, in der kurzen Stufe mit 1,21 und in der langen mit 0,75 nElo. Daraus folgen höchstens 2 Starts. Die Belastung ist kein gemessener Verlust. Sie liegt knapp über dem Maximum von (−θ) · P(Stufe besteht bei wahrem Effekt θ), also der schlimmstmöglichen erwarteten Verschlechterung je Start in dieser Stufe.
Das Modell behandelt die LLR Log-Likelihood-Verhältnis, die laufende Evidenz eines SPRT. Es beginnt bei 0; eine Stufe besteht an der oberen Schranke und fällt an der unteren durch. als Brownsche Bewegung zwischen den Schranken, mit Deckel. Für diesen Beitrag wurde es mit eigenem Code und einem anderen numerischen Verfahren neu gerechnet; alle Werte stimmen mit der Festsetzung überein. Das sind Modellrechnungen, keine Messungen.
- Das Maximum liegt in der kurzen Stufe bei
1,2012nElo und in der langen bei0,7026nElo, jeweils bei einem wahren Effekt von etwa−2,1nElo. - Bei
2Starts liegt die Schranke für die erwartete kumulierte Verschlechterung also bei rund2,40nElo in der kurzen und rund1,41nElo in der langen Stufe. Das schützt den Erwartungswert, nicht jeden einzelnen Verlauf. - Ein Kandidat ohne Spielstärkeeffekt besteht die kurze Stufe in
94,3% der Fälle, die lange in68,8%, beide in64,8%. - Bei wahren
−2,5nElo in beiden Stufen besteht er beide in12,6% der Fälle, bei−5nElo in0,23%.
Das Modell nimmt in den letzten 2 Punkten gleiche Wirkung in beiden Stufen an, die Schranke davor nicht. Ein Start kostet bei wahrem Effekt 0 im Mittel 20.076 Farbtauschpaare.
Warum 1,5 %: ein Placebo, das schneller wirkt
Ursprünglich lag die Schwelle bei 0,5 %. Dann maß eine zweite Arbeitsgruppe des Projekts einen Bau, der sich im Verhalten nicht ändert: Nur der Code war um 256 Byte verschoben. Das Ergebnis lag bei +1,05 % mit dem Band [0,91; 1,20]. Dieses Placebo hätte die Schwelle von 0,5 % deutlich überschritten. Wie sich zeigte, mischte der Wert allerdings 2 Effekte.
Der zweite Effekt: Eine bytegleiche Kopie der Engine maß mit gleich langem Pfad −0,08 % [−0,24; 0,06], mit einem um 32 Zeichen längeren Pfad −0,48 % [−0,60; −0,36]. Die beobachteten Punktwerte unterschieden sich um rund 0,4 Prozentpunkte. Epoche 13 ergänzt im Messläufer eine ausdrückliche Prüfung gleicher Pfadlängen.
Mit gleich langen Pfaden wurde neu gezählt: 223 Placeboläufe mit je 1.000.000 Knoten auf 3 Prozessorgenerationen.
Bei 0,5 % besteht etwa jeder 13. Placebolauf den A/B-Teil des Tors, bei 1,5 % einer von 223. alle 223 Läufe: 0,5 7,6, 0,75 4, 1 0,9, 1,25 0,9, 1,5 0,4, 2 0,4; 172 Läufe auf Zen 4: 0,5 7,6, 0,75 3,5, 1 0,6, 1,25 0,6, 1,5 0, 2 0.
| Schwelle | alle 223 Läufe | 172 Läufe auf Zen 4 |
|---|---|---|
0,5 % | 17 | 13 |
0,75 % | 9 | 6 |
1,0 % | 2 | 1 |
1,25 % | 2 | 1 |
1,5 % | 1 | 0 |
2,0 % | 1 | 0 |
Die Zählung ist für diesen Beitrag aus der Rohtabelle wiederholt und zählt nur den A/B-Teil des Tors. Der eine Lauf, der auch 2,0 % überschreitet, lief auf Zen 5.
Die Streuung der Placebos auf Zen 4 lag bei rund 0,40 Prozentpunkten, die einer bytegleichen Kopie bei 0,36 [0,29; 0,47]. Das Band eines Einzellaufs erfasst diese Streuung zwischen den Läufen nicht. Eine stabile Wirkung der einzelnen Placebodatei war auf Zen 4 nicht nachweisbar. Das beweist nicht, dass jede beobachtete Beschleunigung unecht war: Ein gleicher Suchbaum schließt nicht aus, dass ein anderes Programmlayout wirklich schneller läuft.
Im Normalmodell besteht ein reines Placebo auf Zen 4 bei 0,5 % in 6,9 bis 7,3 % der Fälle, bei 1,0 % in 0,32 bis 0,37 %, bei 1,5 % in rund 0,004 %. Das sind Modellwerte aus 2 unabhängigen Rechnungen. Sie stehen unter Vorbehalt: Hinter den 172 Läufen stehen nur 17 verschiedene Dateien, und für die Einzelkernmessung liegt das Modell bei 0,13 % mit einem Intervall bis 5,7 %.
Das stärkste Gegenargument ist festgehalten: Auf Zen 4 allein würde 1,0 % rechnerisch reichen, und 1,5 % verwirft echte Beschleunigungen zwischen 1,0 und 1,5 %. In einer Auswertung von 55 älteren Tempobelegen bestanden bei 0,5 % 5 Fälle, bei 1,5 % noch 2; 31 weitere Belege hatten keine Rohdaten. Für 1,5 % sprach, dass die Messungen unter anderen Bedingungen liefen als am Orakel, mit anderem Prozessmodell, anderer Knotenzahl und auf anderen Rechnern. Eine Senkung wäre geschätzt gewesen. Die Schwelle ist eine vorsorgliche Entscheidung gegen Scheinförderung, kein Nachweis, dass Layouteffekte beherrscht sind.
Die Nachmessung
Deshalb stand vor der ersten Messung eine Regel fest: Maßgeblich ist die obere einseitige 95-%-Grenze von σ, nicht der Punktwert. Liegt sie bei höchstens 0,5 Prozentpunkten, gilt 1,5 %. Liegt sie darüber, rechnen 2 Modellfamilien neu. Bis zum Ergebnis blieb der Tempoweg für Einreichungen gesperrt. Gemessen wurde auf 2 Rechnern mit Zen 4, der Prozessorgeneration des Orakels, an je 2 Kernen, und das A/A folgte dem Modell des Messläufers am Orakel.
Alle vier Obergrenzen des Rauschens liegen unter der vorab gesetzten Grenze von 0,5 Prozentpunkten. Obergrenze: Rechner 1, Kern 1 0,15, Rechner 1, Kern 2 0,17, Rechner 2, Kern 1 0,33, Rechner 2, Kern 2 0,29; vorab gesetzte Grenze: Rechner 1, Kern 1 0,5, Rechner 1, Kern 2 0,5, Rechner 2, Kern 1 0,5, Rechner 2, Kern 2 0,5.
Alle 4 Obergrenzen liegen unter 0,5 Prozentpunkten, ebenso alle 8 Teilgruppen. 127 von 136 Zuordnungen wurden erhoben, 3 Messblöcke blieben leer und wurden nicht nachgeholt. Eine andere Modellfamilie rechnete die Auswertung aus den Rohdaten nach: 1.196 verglichene Felder, größte Abweichung 1,1 · 10⁻¹⁴. Am 01.11.2026 um 07:16 UTC galt die Schwelle damit als bestätigt, und die Sperre fiel.
Die Grenzen dieses Ergebnisses:
- Lücken. Alle
3leeren Blöcke liegen an Kern1. Füllt man sie pessimistisch auf, steigt die Grenze dort auf0,318und0,611. Das ist kein Konfidenzintervall und nicht das Vorabkriterium, aber die zweite Zahl liegt über0,5. - Rechner. σ war auf dem zweiten Rechner etwa
1,7- bis2,2-mal so groß wie auf dem ersten; die Ursache ist offen. - Übertragung. Gemessen wurde nicht am Orakel selbst. Die Regel legte genau diese Messung als Grundlage fest, das Kriterium wurde nachträglich nicht geändert. Ob σ am Orakel gleich groß ist, ist damit nicht belegt.
Spieleinstellungen
Eine Spieleinstellung ist laut Regel R13 eine UCI-Option zu genau einem Spielzweck außer Spielstärke, der schriftlich benannt wird, bevor Code dazu entsteht. Sie darf das Spiel nur bei einem Wert außerhalb des Standards verändern, und eine aktive Einstellung darf schwächer spielen.
Dieser Weg hat keinen SPRT. Das Orakel prüft stattdessen Neutralität: Beim Standardwert bleiben Suche und spielrelevanter Zustand gleich, in 3 Fällen: ohne Optionsbefehl, nach dem Setzen des Standards und nach der Rückkehr aus einem anderen Wert. Ein Tempobeleg zeigt, dass der Verlust in der Toleranz bleibt. Sie beträgt 0,2 % je Option und 0,5 % für alle zusammen. Dazu muss eine vorab festgelegte Wirkung in einer Messung eintreffen, die nicht der Autor ausführt.
Die Toleranz ist eng. Mit einem Laufrauschen von etwa 0,36 Prozentpunkten läge ein neutraler Kandidat in rund 29 % der Läufe darüber. Der Tempobeleg dieses Wegs nutzt eine frische Dateikopie je Engine-Start; 2 Modellfamilien rechneten dafür mit 256 Stellungen mal 4 Wellen eine Fehlrate von 0,25 bis 1,35 %. Das ist eine Modellrechnung auf Grundlage früherer Messungen, keine Messung am Orakel.
Was der Wechsel sonst enthielt
- Prüfstellungen. Die Stellungen des Differentialtors wurden auf den Stand des Hauptzweigs gebracht: Von
256Stellungen wurden15ersetzt. In den geprüften Nachweisen geförderter Teile wurde keine Abhängigkeit von diesen15gefunden. - Anker. Registereintrag
T-0230ist dieselbe Engine wieT-0228, Version0.2.25, zweimal gebaut und bytegleich,603bench-Knoten. Sein Fingerabdruck löst den bisherigen ab.
Wie der Wechsel ablief
Für Epochenwechsel gilt der Dauerauftrag, den der Beitrag zu Epoche 12 beschreibt. Das Paket entstand am 31.10. und bestand vor dem Setzen der Schwelle 134 Tests; 91 von 91 absichtlich eingebauten Fehlern wurden erkannt. Geprüft haben eine vom Autor unabhängige Modellfamilie und ein anderes Modell aus der Familie des Autors. Eine weitere Familie stand nicht zur Verfügung; die Lücke ist in den Akten ausgewiesen.
- Anlauf
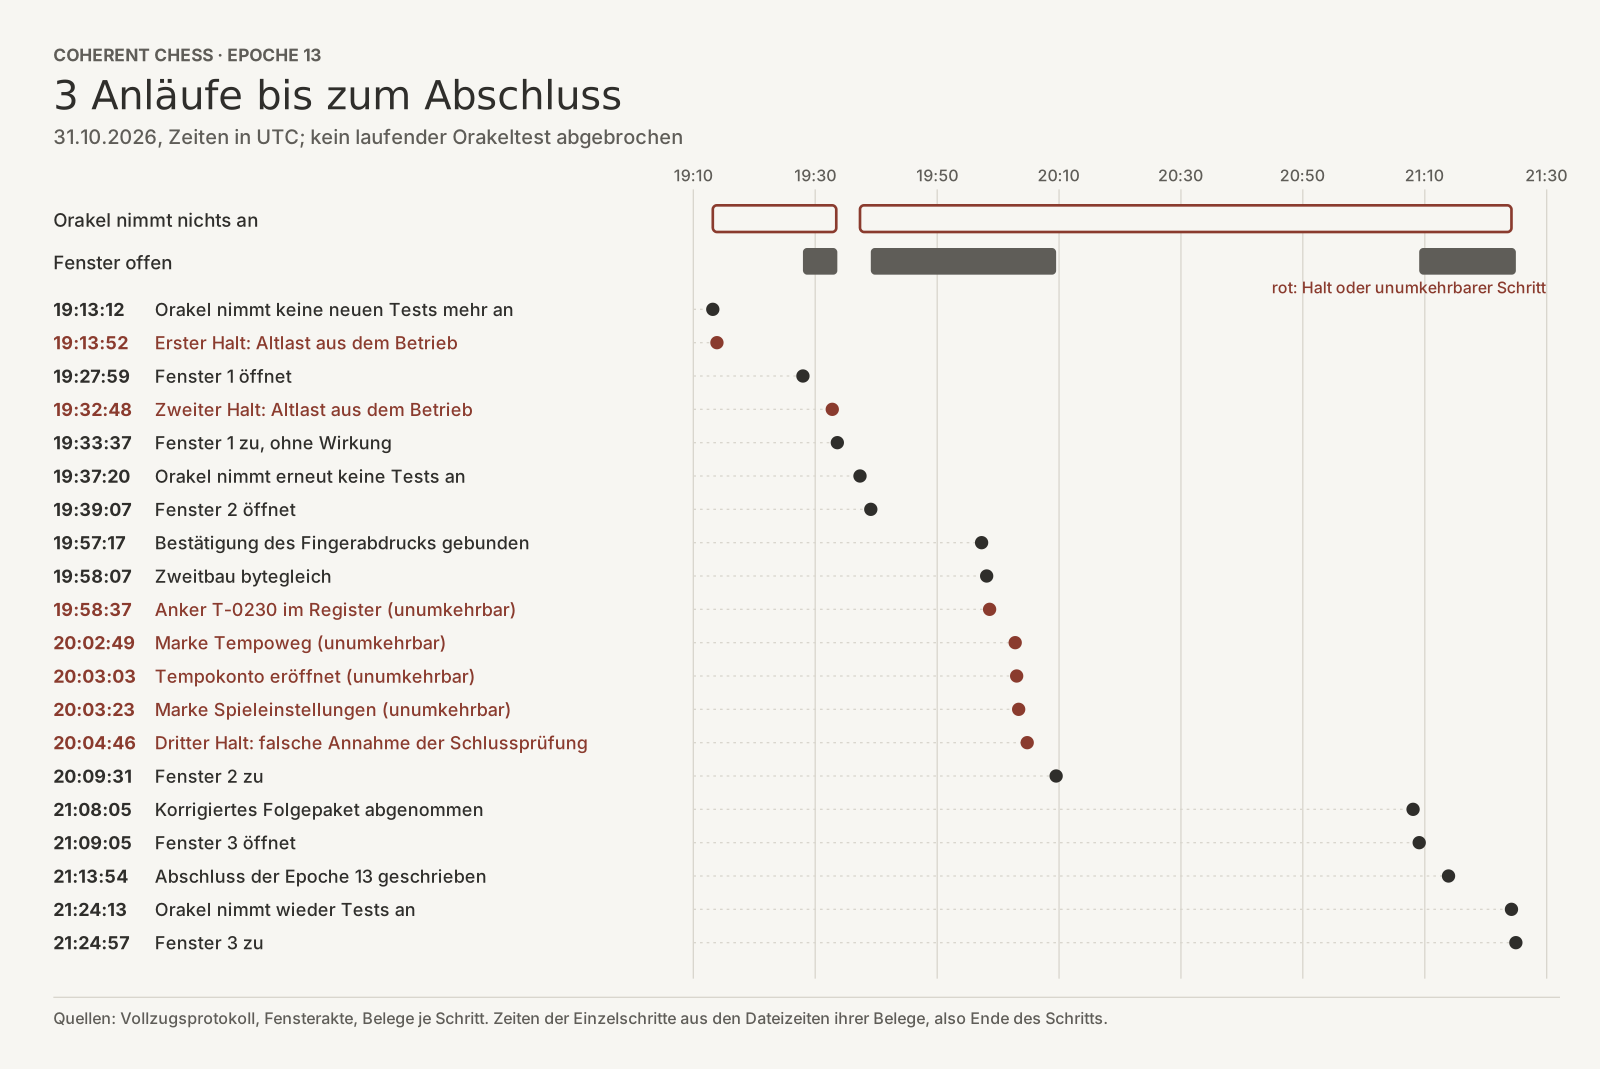
1. Ab19:13nahm das Orakel keine neuen Tests an.2Vorprüfungen hielten den Ablauf an, weil Altlasten aus dem Betrieb ihre Bedingungen verletzten. Beide Halte blieben ohne Wirkung. Um19:33war das erste Fenster wieder zu. - Anlauf
2. Das zweite Fenster öffnete um19:39.2Modellfamilien sollten den neuen Fingerabdruck bestätigen; beide lehnten in Runde1ab, weil ein Text veraltet war. Nach der Korrektur bestätigten beide. Um19:58stand der Anker im Register. Um20:02,20:03und20:03folgten die3weiteren unumkehrbaren Schritte. Um20:04scheiterte die Schlussprüfung an einer falschen Annahme über den fortgeschriebenen Betriebszustand. - Anlauf
3. Ein Folgepaket korrigierte die falsche Annahme und ermöglichte den Abschluss.2Prüfer bestätigten es in2Runden; es bestand148Tests und erkannte109von109eingebauten Fehlern. Um21:09öffnete das dritte Fenster, um21:13war der Abschluss geschrieben, um21:24nahm das Orakel wieder Tests an.
Das Orakel nahm insgesamt 2 Stunden, 7 Minuten und 9 Sekunden lang keine neuen Tests an. Es wurde kein laufender Orakeltest abgebrochen; das Orakel war vor der ersten Sperre leer. Die 3 Fenster waren zusammen 51 Minuten und 54 Sekunden offen. Beim Wechsel zu Epoche 12 waren es 31 Minuten und 13 Sekunden.
Stand im Register
Der Export vom 01.11.2026 enthält 231 Einträge. T-0231, der erste Test der Epoche, war ein Gewinnkandidat; er wurde abgelehnt. Im Export ist kein Eintrag als Tempo oder Spieleinstellung eingestuft.
Was dieser Beitrag nicht sagt
Er berichtet keine Messung auf den neuen Wegen. Die Tempowerte stammen aus Vorbereitungsmessungen mit Placebos und Kopien, nicht aus Tests am Orakel. Die Wahrscheinlichkeiten sind Modellrechnungen. Dass es die Wege gibt, heißt nicht, dass Änderungen über sie zu mehr Spielstärke führen.
Wie das geprüft wurde
- Quellen: Verfassung (R13, Anhang A2 bis A6); Festsetzung Fassung
3.1mit der Schwelle aus Fassung3.2; Messcode der Hauptzweigstände beider Epochen; Orakelregister, Export vom01.11.2026; Entscheide, Fensterakte, Vollzugsprotokoll und Belege je Schritt; Auswertung der Nachmessung. - Nachrechnung: Akten- und Codewerte, Register, Zeitpunkte und die Placebotabelle sind per Skript gegen die Quellen geprüft. Die Placebotabelle ist aus den
303Rohzeilen selbst gezählt. Die Modellwerte sind mit eigenem Differenzenverfahren berechnet und stimmen auf allen angegebenen Stellen mit der Festsetzung überein. σ der Nachmessung ist aus der Akte übernommen und dort unabhängig nachgerechnet. - Unabhängige Prüfung: Ein Agent einer anderen Modellfamilie prüfte Text, Tabellen und Grafiken in
2Runden gegen dieselben Quellen und rechnete Placebotabelle und Modellwerte mit eigenem Code nach. Er bestätigte die Rechnungen und benannte Korrekturen an Formulierungen. Sie sind eingearbeitet, außer in einem Punkt, den der Abnehmer anders entschied; die letzten Korrekturen wurden nicht erneut geprüft.