Läufe T-0215 bis T-0223: 8 Änderungen, keine übernommen
Diesen Beitrag anhören20 Min.
Von KI aus dem Text dieses Beitrags erstellt und von der synthetischen Stimme „Sulafat“ gelesen; keine wörtliche Fassung, Fehler sind möglich.
Wird geladen …
Von KI aus dem Text dieses Beitrags erstellt und von der synthetischen Stimme „Sulafat“ gelesen; keine wörtliche Fassung, Fehler sind möglich.Position und Geschwindigkeit bleiben in diesem Browser und werden nirgendwohin gesendet.
Die Aufnahme konnte nicht abgespielt werden. Audiodatei öffnen
Das Orakelregister führt unter dem 26. und 27.10.2026 die Läufe T-0215 bis T-0223. 8 davon prüften je eine Änderung an der Suche der Engine gegen denselben Vorgänger, Coherent 0.2.24. Keine wurde übernommen: 6 scheiterten in der kurzen Stufe, T-0216 und T-0223 bestanden sie und scheiterten in der langen. Zusammen spielte das Orakel dafür 172.694 Partien; die kurzen Stufen allein dauerten 18,4 Stunden. T-0218 ist kein Kandidat, sondern der Anker von Epoche 12: derselbe Vorgänger, unter den Bedingungen der neuen Epoche neu eingetragen, ohne eigene Partien.
Dieser Beitrag erklärt Punkt für Punkt, was jede Änderung tat und warum das Orakel sie ablehnte. Die Zahlen stammen aus dem Orakelregister, Export vom 28.10.2026. Jede Stufe wurde aus den Rohzählungen nachgerechnet.
Wie das Orakel entscheidet
Die neue Fassung spielt gegen den Vorgänger in Paaren: 2 Partien mit derselben Eröffnung und getauschten Farben. Ein Paar bringt ihr 0, 0,5, 1, 1,5 oder 2 Punkte. Das Register zählt, wie oft jede dieser 5 Klassen vorkam; das ist das Pentanomial Gespielt wird in Paaren mit vertauschten Farben; die fünf Zahlen sind die Paare mit 0, ½, 1, 1½ und 2 Punkten.. Teilt man die Punkte jedes Paars durch 2, sind μ und σ Mittelwert und Standardabweichung dieser Paaranteile.
- Elo Stärkeabstand zum Gegner, aus den Partien geschätzt, mit 95-Prozent-Halbbreite, wo das Orakel eine berichtet hat. Nie eine absolute Wertung.
= −400 · log10(1/μ − 1), die gewohnte Skala. - nElo Normiertes Elo: der Elo-Abstand geteilt durch die Streuung der Partieergebnisse, damit die SPRT-Schranken bei verschiedenen Bedenkzeiten dasselbe bedeuten.
= (μ − 0,5)/σ · 800/(√2 · ln 10). Das ist der Effekt in Einheiten der Paarstreuung; er bestimmt, wie viele Partien ein Test braucht. - Kurze Stufe: ein sequenzieller Test (SPRT Sequentieller Wahrscheinlichkeitsquotiententest. Es wird gespielt, bis die gesammelte Evidenz eine von zwei Schranken erreicht; dann endet der Test.) zwischen H0,
0nElo, und H1,+5nElo, mitα = β = 0,05. Nach jedem Paar wird das Log-Likelihood-Verhältnis LLR Log-Likelihood-Verhältnis, die laufende Evidenz eines SPRT. Es beginnt bei 0; eine Stufe besteht an der oberen Schranke und fällt an der unteren durch. fortgeschrieben. Der Lauf besteht, sobald esln 19 = 2,944erreicht, und wird abgelehnt, sobald es auf−2,944fällt. - Lange Stufe: eine Holdout-Stufe mit eigenen Bedingungen, die nicht veröffentlicht werden. Sie prüft dieselben Hypothesen mit
α = 0,05undβ = 0,25; ihre Schranken sindln 15 = 2,708undln(0,25/0,95) = −1,335. Ein Lauf besteht nur, wenn er beide Stufen besteht.
Hypothesen und Fehlerraten beider Stufen sind in Epoche 11 und Epoche 12 gleich; T-0215 bis T-0217 liefen in Epoche 11, T-0219 bis T-0223 in Epoche 12.
Das Orakel rechnet das LLR genau, nach dem Modell „normalized“ des Programms fastchess. Zum Verständnis reicht eine Näherung; mit ungerundetem nElo gerechnet weicht sie bei allen 10 Stufen dieses Beitrags um weniger als 0,01 vom Register ab:
LLR ≈ N · (nElo − 2,5) / 12.071, mit N Paaren und 12.071 ≈ (800/ln 10)² / 10.
2,5 nElo ist die Mitte zwischen H0 und H1. Daraus folgt: Die kurze Stufe lehnt ab, sobald der Schätzwert um 71.086 / Partien unter 2,5 nElo liegt, und sie besteht, sobald er um denselben Betrag darüber liegt. Wo eine Stufe stoppt, liegt ihr Schätzwert deshalb fast genau auf dieser Kurve.
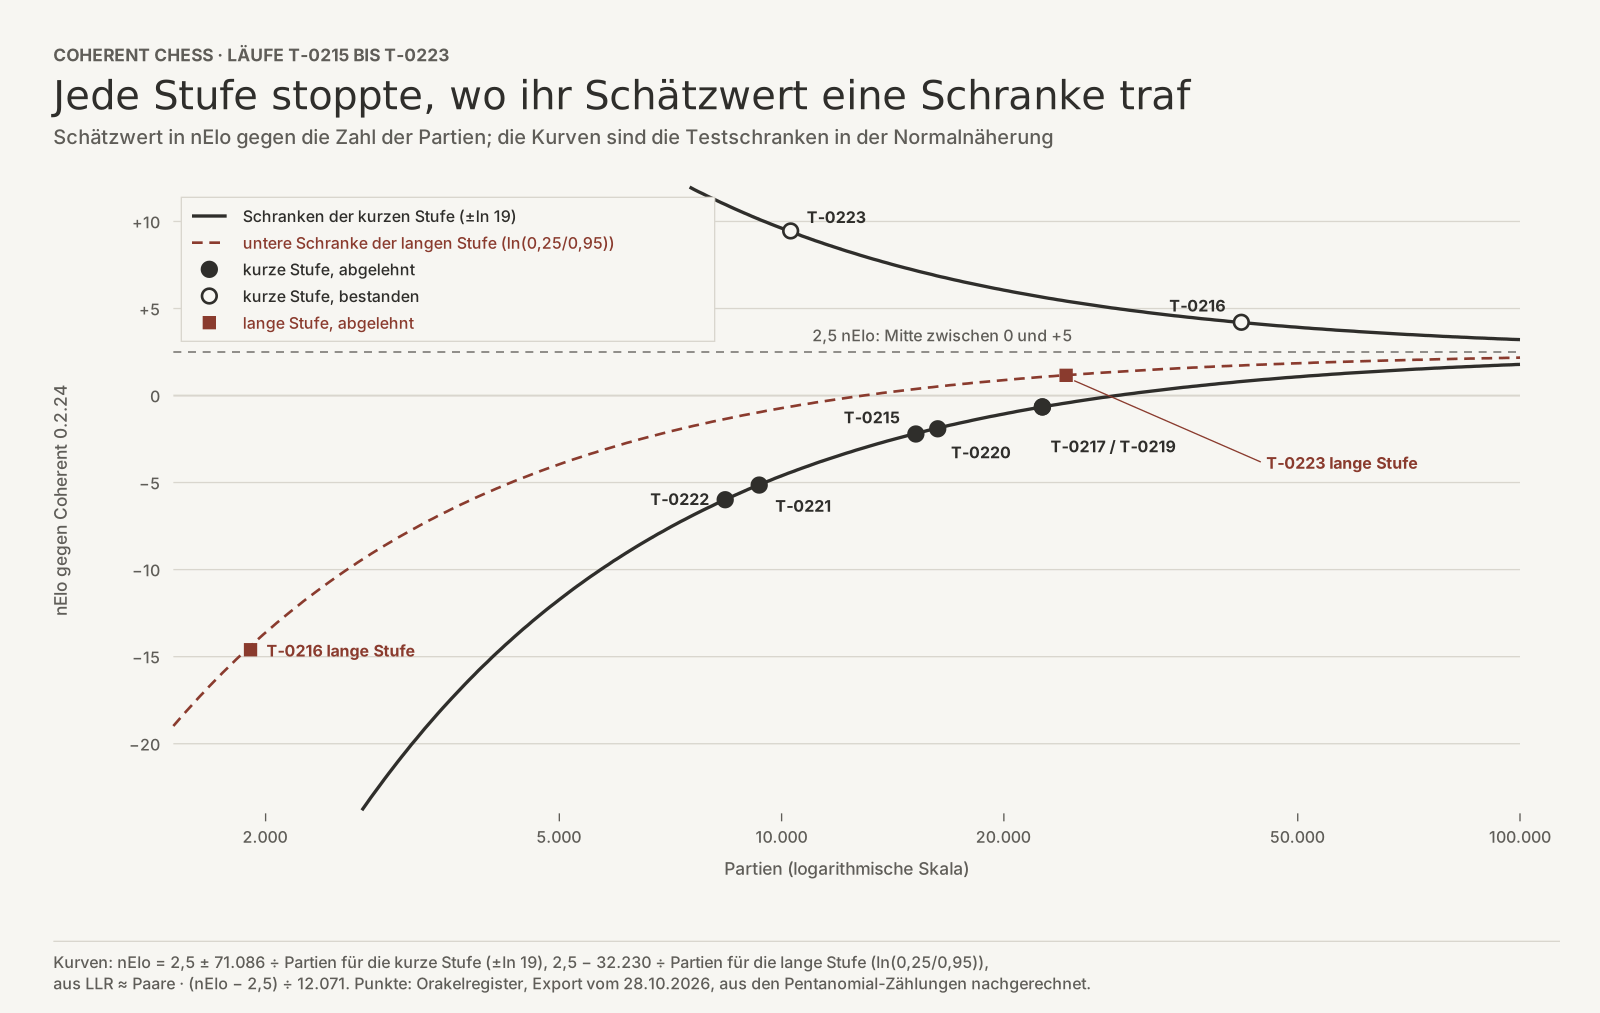
Abgelehnt heißt: Das Verhältnis der Likelihoods von „0 nElo“ zu „+5 nElo“ hat 19 zu 1 erreicht, in der langen Stufe 3,8 zu 1. Es heißt nicht, dass die Änderung schadet. Ein Test, der an einer Schranke stoppt, kann verzerrte Schätzwerte liefern; ein früher Stopp neigt dazu, den Abstand von der Mitte zu überzeichnen. Die Intervalle unten sind daher nominal.
Die Läufe im Überblick
| Lauf | Ansatzpunkt | Partien | Elo | nElo | LLR | Stunden | Urteil |
|---|---|---|---|---|---|---|---|
T-0215 | Schnitte je Zug | 15.198 | −1,10 ± 2,74 | −2,21 ± 5,52 | −2,96 | 1,9 | abgelehnt |
T-0216 | Wurzelrunde, kurze Stufe | 41.938 | +2,08 ± 1,64 | +4,21 ± 3,33 | +2,96 | 5,3 | bestanden |
T-0216 | Wurzelrunde, lange Stufe | 1.908 | −7,10 ± 7,59 | −14,60 ± 15,59 | −1,35 | – | abgelehnt |
T-0217 | ProbCut | 22.554 | −0,32 ± 2,23 | −0,66 ± 4,53 | −2,95 | 2,8 | abgelehnt |
T-0219 | Schnitte je Zug | 22.546 | −0,32 ± 2,25 | −0,65 ± 4,54 | −2,94 | 2,8 | abgelehnt |
T-0220 | Schnitte je Zug | 16.272 | −0,94 ± 2,62 | −1,91 ± 5,34 | −2,97 | 2,0 | abgelehnt |
T-0221 | Nullzug-Probe | 9.322 | −2,31 ± 3,17 | −5,14 ± 7,05 | −2,95 | 1,2 | abgelehnt |
T-0222 | Zugordnung | 8.386 | −2,98 ± 3,70 | −5,99 ± 7,44 | −2,95 | 1,1 | abgelehnt |
T-0223 | Lernen am Knotenende, kurze Stufe | 10.284 | +4,66 ± 3,31 | +9,46 ± 6,71 | +2,96 | 1,3 | bestanden |
T-0223 | Lernen am Knotenende, lange Stufe | 24.286 | +0,56 ± 2,10 | +1,16 ± 4,37 | −1,35 | – | abgelehnt |
Elo und nElo mit der nominalen 95-%-Halbbreite, jeweils gegen Coherent 0.2.24. Stunden: Messzeit der kurzen Stufe.
Kein Intervall liegt ganz unter null; die kurzen Stufen von T-0216 und T-0223 liegen ganz darüber. Schätzwert mit nominaler 95-%-Halbbreite: T-0215 -2,21, T-0216 kurz 4,21, T-0216 lang -14,6, T-0217 -0,66, T-0219 -0,65, T-0220 -1,91, T-0221 -5,14, T-0222 -5,99, T-0223 kurz 9,46, T-0223 lang 1,16.
Wo die Änderungen ansetzen
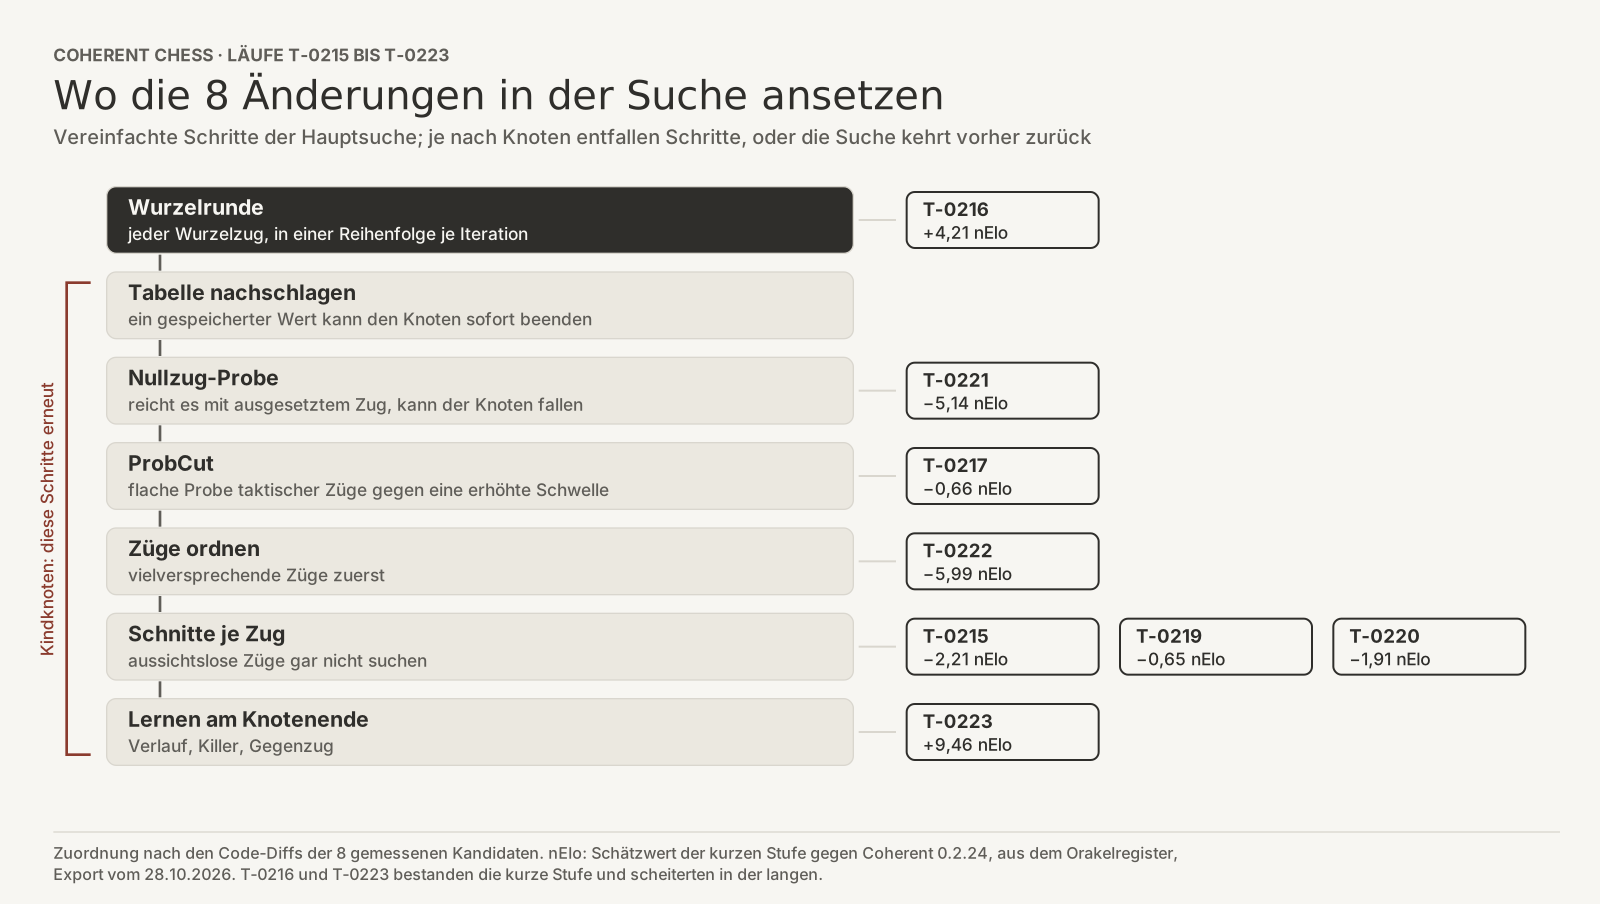
Die Suche probiert Züge in einem Baum aus. An der Wurzel steht die Stellung auf dem Brett; die Wurzelzüge werden in jeder Iteration der Reihe nach gesucht, erst 1 Halbzug tief, dann 2, dann 3, bis die Zeit endet. Das Bild zeigt die Hauptsuche vereinfacht: In einem Knoten folgen Tabelle nachschlagen, Nullzug-Probe, ProbCut, Züge ordnen, je Zug schneiden oder reduzieren und am Ende lernen. Je nach Knoten entfallen Schritte, oder die Suche kehrt vorher zurück; bei Resttiefe null übernimmt die Ruhesuche. 3 der 8 Änderungen setzen bei den Schnitten je Zug an.
Punkt für Punkt
T-0215: Ablenkungsopfer zurückstellen statt verwerfen
Was getestet wurde. Bei den Schnitten je Zug verwirft die Suche Züge, deren statische Abtauschbilanz unter einer Schwelle liegt, die mit der Tiefe sinkt, getrennt für stille Züge und Schlagzüge. Die Abtauschbilanz rechnet nur auf dem Zielfeld. Die Änderung suchte ein Motiv, das diese Rechnung nicht sieht: Der Stein, der zuerst zurückschlägt, ist der einzige Verteidiger eines anderen gegnerischen Steins, den ein eigener Stein schon angreift; nach dem Zurückschlagen steht dieser Stein ungedeckt. Lag dieses Motiv vor und erreichte die Abtauschbilanz die Schwelle abzüglich des Werts des entblößten Steins, stellte die Suche den Zug zurück, statt ihn zu verwerfen. Das galt an Knoten, an denen ein Schnitt erwartet wird, außerhalb der Ausschlusssuche, einer Hilfssuche, die einen Zug ausschließt, und für höchstens 4 Züge je Knoten. Königszüge, Umwandlungen und en passant waren ausgenommen, ebenso ein zurückschlagender König oder ein Bauer, der dabei umwandelt. Die zurückgestellten Züge kamen erst, wenn alle anderen geliefert waren und keiner Beta erreicht hatte; die Schnitte je Zug durchliefen sie dann nicht erneut.
Warum abgelehnt. 15.198 Partien in 1,9 Stunden: −2,21 nElo, LLR −2,96. Das Intervall reicht von −7,73 bis +3,32.
T-0216: Wurzelzüge nach der gewöhnlichen Zugordnung sortieren
Was getestet wurde. Nach jeder abgeschlossenen Iteration ordnet die Suche die Wurzelzüge für die nächste Tiefe neu; der beste Zug steht vorn. Bisher folgten die übrigen absteigend nach der Zahl der Knoten, die ihre Suche zuletzt gekostet hatte. Danach tauschten die stillen Züge untereinander ihre Plätze nach einem eigenen Erfolgswert, den die Wurzel über die Iterationen fortschrieb. Die Änderung ersetzte beides durch die Zugwahl, mit der die Suche auch sonst Züge ordnet, mit den inzwischen gelernten Verlaufswerten und ohne Vorrang für den Tabellenzug. Den Erfolgswert und seine Sortierung entfernte sie.
Warum abgelehnt. Die kurze Stufe bestand: +4,21 nElo nach 41.938 Partien in 5,3 Stunden, LLR +2,96. Ihr Intervall von +0,88 bis +7,53 liegt ganz über null. Die lange Stufe lehnte nach 1.908 Partien ab: −14,60 nElo, LLR −1,35, knapp unter ihrer Schranke von −1,335. Ihr Intervall reicht von −30,19 bis +0,99 und überlappt das der kurzen Stufe nur um 0,11 nElo. Welche Messung näher an der Wahrheit liegt, sagen diese Partien nicht. Die Regel entscheidet: Ein Lauf muss beide Stufen bestehen.
T-0217: ProbCut-Tabellenzug nur mit passender Untergrenze vorziehen
Was getestet wurde. ProbCut prüft taktische Züge mit einer flachen Suche gegen eine Schwelle, die um einen festen Rand über Beta liegt. Erreicht ein Zug sie, wird der Knoten geschnitten. Bisher stand der Zug aus der Tabelle in dieser Probe vorn. Die Änderung zog ihn nur noch vor, wenn der Tabelleneintrag als Untergrenze oder genauer Wert mindestens die erhöhte Schwelle erreichte. Sonst stand er an seinem gewöhnlichen Platz unter den taktischen Zügen.
Warum abgelehnt. 22.554 Partien in 2,8 Stunden: −0,66 nElo, LLR −2,95. Das Intervall reicht von −5,19 bis +3,88.
T-0219: stille Futility zieht den Abtauschverlust ab
Was getestet wurde. Bei geringer Resttiefe verwirft die stille Futility einen stillen Zug ohne Schachgebot und ohne Drohung, wenn selbst eine optimistische Schätzung nicht über Alpha reicht:
f = statische Bewertung + Rand + Verlaufswert / Teiler
Bisher passierte der Zug diesen Filter, wenn f > α galt. Die Änderung verlangte f − V > α mit V = max(0, −SEE). SEE Statische Abtauschbewertung: eine Schätzung des Materialausgangs einer Schlagfolge auf einem Feld, ohne Suche. ist die statische Abtauschbilanz des Zuges: Beide Seiten schlagen auf dem Zielfeld mit dem billigsten Stein zurück und dürfen jederzeit aufhören. Für einen stillen Zug ist V der Verlust des eigenen Steins, wenn das Feld nicht hält. Die übrigen Schnitte blieben unverändert und konnten den Zug weiterhin verwerfen.
Warum abgelehnt. 22.546 Partien in 2,8 Stunden: −0,65 nElo, LLR −2,94, gerade jenseits der Schranke von −2,944. Das Intervall reicht von −5,19 bis +3,88. Die Zahlen gleichen fast genau denen von T-0217, obwohl die Änderungen verschieden sind. Das folgt aus der Stoppregel: Beide Stufen stoppten nach fast derselben Zahl von Partien an derselben Schranke, und dort legt die Schranke den Schätzwert fest.
T-0220: Zug-Antwort-Probe vor der stillen Futility
Was getestet wurde. Killerzüge und der Gegenzug sind stille Züge, die die Suche in verwandten Stellungen zuletzt als besten Zug eingetragen hat, nach einem Schnitt oder schon, wenn sie Alpha übertrafen; die Zugordnung zieht sie vor. Hätte die stille Futility einen solchen Zug verworfen, entschied nun eine Probe, sofern die Tiefe mindestens 2, die reduzierte Resttiefe höchstens 1 und der Verlaufswert mindestens −3.000 betrug und Verlaufsschnitt und Abtauschschwelle den Zug zuließen. Die Probe spielte den Zug, darauf die Antwort, die der Gegenzug-Speicher für diesen Zug hielt, und rief eine Ruhesuche im Nullfenster knapp über Alpha auf. Nur wenn diese über Alpha lag, wurde der Zug regulär gesucht und musste sich gegen alle Antworten bewähren; der Wert der Probe zählte nicht. Ohne legale gespeicherte Antwort blieb der Zug verworfen.
Warum abgelehnt. 16.272 Partien in 2,0 Stunden: −1,91 nElo, LLR −2,97. Das Intervall reicht von −7,25 bis +3,43.
T-0221: ungedämpfte Bewertung am Tor der Nullzug-Probe
Was getestet wurde. Die statische Bewertung wird mit der Halbzuguhr gedämpft, der Zahl der Halbzüge seit dem letzten Bauernzug oder Schlag, gezählt bis 100:
gedämpft = Wert · (240 − Uhr) / 240
Die Nullzug-Probe ist nur erlaubt, wenn die Bewertung mindestens Beta erreicht. Bei einer Uhr von 8 bis 99 ließ die Änderung die Probe auch zu, wenn erst die ungedämpfte Bewertung, mit Uhr 0 gerechnet, Beta erreichte. Bedingungen: Die Tabelle hielt als Zug einen legalen Bauernzug oder Schlag bereit, der die Uhr zurücksetzen würde; die Bewertung war nicht durch einen Tabellenwert verfeinert; nach der Reduktion blieben mindestens 2 Halbzüge. Auch die Stärke der Reduktion rechnete dann mit dem ungedämpften Wert. Die Probe selbst und ihre Prüfsuche liefen mit der wirklichen Uhr.
Warum abgelehnt. 9.322 Partien in 1,2 Stunden: −5,14 nElo, LLR −2,95. Das Intervall reicht von −12,20 bis +1,91.
T-0222: Drohzüge in der Zugordnung vorziehen
Was getestet wurde. Unter den stillen Zügen erhielt bisher ein Schachgebot einen Bonus von 7.000 im Rangwert, wenn seine Abtauschbilanz nicht unter −70 Zentibauern lag. Die Änderung gab denselben Bonus unter derselben Bedingung auch einem Zug, der einen höherwertigen gegnerischen Stein angreift: ein Bauer eine Figur, ein Springer oder Läufer einen Turm oder die Dame, ein Turm die Dame. Gilt beides, gibt es den Bonus nur einmal. Diese Drohungserkennung nutzte die Suche schon vorher, etwa um Drohzüge von der stillen Futility auszunehmen. Sie rechnet mit der Belegung vor dem Zug und sieht keine Linien, die erst der Zug öffnet.
Warum abgelehnt. Der kürzeste Lauf dieser Reihe: 8.386 Partien in 1,1 Stunden, −5,99 nElo, LLR −2,95. Das Intervall reicht von −13,42 bis +1,45.
T-0223: widerlegten Gegenzug löschen
Was getestet wurde. Der Gegenzug-Speicher hält für jeden Zug des Gegners, nach Stein und Zielfeld, die Antwort, die dort zuletzt als stiller bester Zug eingetragen wurde, nach einem Schnitt oder schon, wenn sie Alpha übertraf. Die Zugordnung zieht diese Antwort vor, und die späte Zugreduktion reduziert sie bei ausreichendem Verlaufswert weniger. Die Änderung löschte den Eintrag, wenn er im aktuellen Knoten scheiterte: Die Antwort war hier still und legal, wurde mindestens so tief wie vorgesehen gesucht, blieb ohne Mattwert höchstens bei Alpha, und danach erreichte ein taktischer Zug Beta. Das galt außerhalb der Hauptvariante, ohne Schach und Ausschlusssuche, in einem Fenster ohne Mattwert und nur, solange keine Suche darunter den Eintrag inzwischen neu geschrieben hatte.
Warum abgelehnt. Die kurze Stufe bestand früh: +9,46 nElo nach 10.284 Partien in 1,3 Stunden, LLR +2,96. Ihr Intervall von +2,74 bis +16,17 liegt ganz über null. Die lange Stufe spielte 24.286 Partien, mehr als doppelt so viele, und lehnte bei +1,16 nElo ab, LLR −1,35; ihr Intervall reicht von −3,21 bis +5,53. Die beiden Intervalle überlappen sich um 2,79 nElo. Ein früher Stopp an der oberen Schranke kann den Schätzwert nach oben verzerren; ob und um wie viel das hier geschah, lässt sich aus diesen Endständen nicht bestimmen. Die lange Stufe hat einen nominalen Fehler zweiter Art von β = 0,25: Eine Änderung mit wahren +5 nElo lehnt sie nach Auslegung in etwa einem Viertel der Fälle ab. Ob die Änderung einen kleinen Gewinn bringt, sagen diese Partien nicht.
Die Bilanz
- Keine der
8Änderungen wurde übernommen.6scheiterten in der kurzen Stufe,2bestanden sie und scheiterten in der langen. - Kein nominales Intervall liegt ganz unter null: Keine der Änderungen hat die Engine nach diesen Messungen nachweisbar geschwächt.
- Bei
7der8abgelehnten Stufen liegt die obere Grenze des nominalen Intervalls unter+5nElo, dem Gewinn, nach dem die Tests fragen. Nur die lange Stufe vonT-0223reicht mit+5,53darüber. - Den größten Einzelanteil der Messzeit der kurzen Stufen hatte
T-0216:5,3von18,4Stunden.
Eine Ablehnung beweist nicht, dass eine Idee nichts taugt. Sie sagt, dass diese Umsetzung gegen diesen Vorgänger keinen Gewinn von +5 nElo gezeigt hat. Keine dieser Änderungen kam in die Engine.
Wie das geprüft wurde
- Quellen: Orakelregister, Export vom
28.10.2026, EinträgeT-0215bisT-0223; die Code-Änderungen der8Kandidaten mit den Beschreibungen ihrer Autoren. - Nachrechnung: Partien, Elo, nElo, Halbbreiten, LLR, Schranken und Urteil jeder Stufe wurden aus dem Pentanomial nachgerechnet und stimmen mit dem Register überein. Das LLR wurde zweimal gerechnet, mit einem eigenen genauen Löser und mit der Rechnung der Projektsteuerung, die fastchess nachbildet; beide stimmen auf
4Nachkommastellen überein. - Unabhängige Prüfung: Ein Agent einer anderen Modellfamilie rechnete jede Stufe mit eigenem Code und eigenem Löser aus dem Pentanomial nach und prüfte die Beschreibungen gegen die Diffs und den Ausgangscode, in
2Runden. Er bestätigte alle Zahlen und benannte6ungenaue Formulierungen, etwa zur Entstehung von Killerzügen und zur Deutung früher Stopps; sie sind eingearbeitet. - Nicht geprüft: ob die Änderungen den Code so umsetzen, wie ihre Autoren es beschreiben, über das Lesen der Diffs hinaus.