Die Etikettenfehlerkurve: Genauigkeit, Kosten und Wirkung tieferer Etiketten
Diesen Beitrag anhören17 Min.
Von KI aus dem Text dieses Beitrags erstellt und von der synthetischen Stimme „Sulafat“ gelesen; keine wörtliche Fassung, Fehler sind möglich.
Wird geladen …
Von KI aus dem Text dieses Beitrags erstellt und von der synthetischen Stimme „Sulafat“ gelesen; keine wörtliche Fassung, Fehler sind möglich.Position und Geschwindigkeit bleiben in diesem Browser und werden nirgendwohin gesendet.
Die Aufnahme konnte nicht abgespielt werden. Audiodatei öffnen
Coherent trainiert sein Bewertungsnetz mit Stellungen aus eigenen Partien. Jede Stellung bekommt als Etikett die Bewertung einer Suche der Engine, in der Datenerzeugung mit 5.000 Knoten je Zug. Eine tiefere Suche kostet mehr Rechenzeit. Die Messreihe „Etikettenbudget“ hat gemessen, wie nah die Etiketten je nach Knotenzahl an einer tiefen Referenzsuche liegen, was sie kosten und ob ein Netz aus tieferen Etiketten mehr lernt. Ein Beitrag vom 26.10.2026 zeigte daraus Auszüge; dieser Beitrag stellt die ganze Messreihe dar. Er entstand im Auftrag des Betreibers und macht keine Aussage über Spielstärke: Alle Maße messen den Abstand zu einer tiefen Referenzsuche derselben Engine oder die Vorhersage des Partieausgangs.
Kurz gesagt
- Der Etikettenfehler gegenüber der Referenzsuche sinkt von
6,19Tausendsteln bei625Knoten über3,58bei5.000Knoten auf1,13bei80.000Knoten. - Die Rechenzeit je Partie steigt bei
20.000Knoten auf das3,57-Fache, bei40.000Knoten auf das6,91-Fache. - Netze, die aus denselben
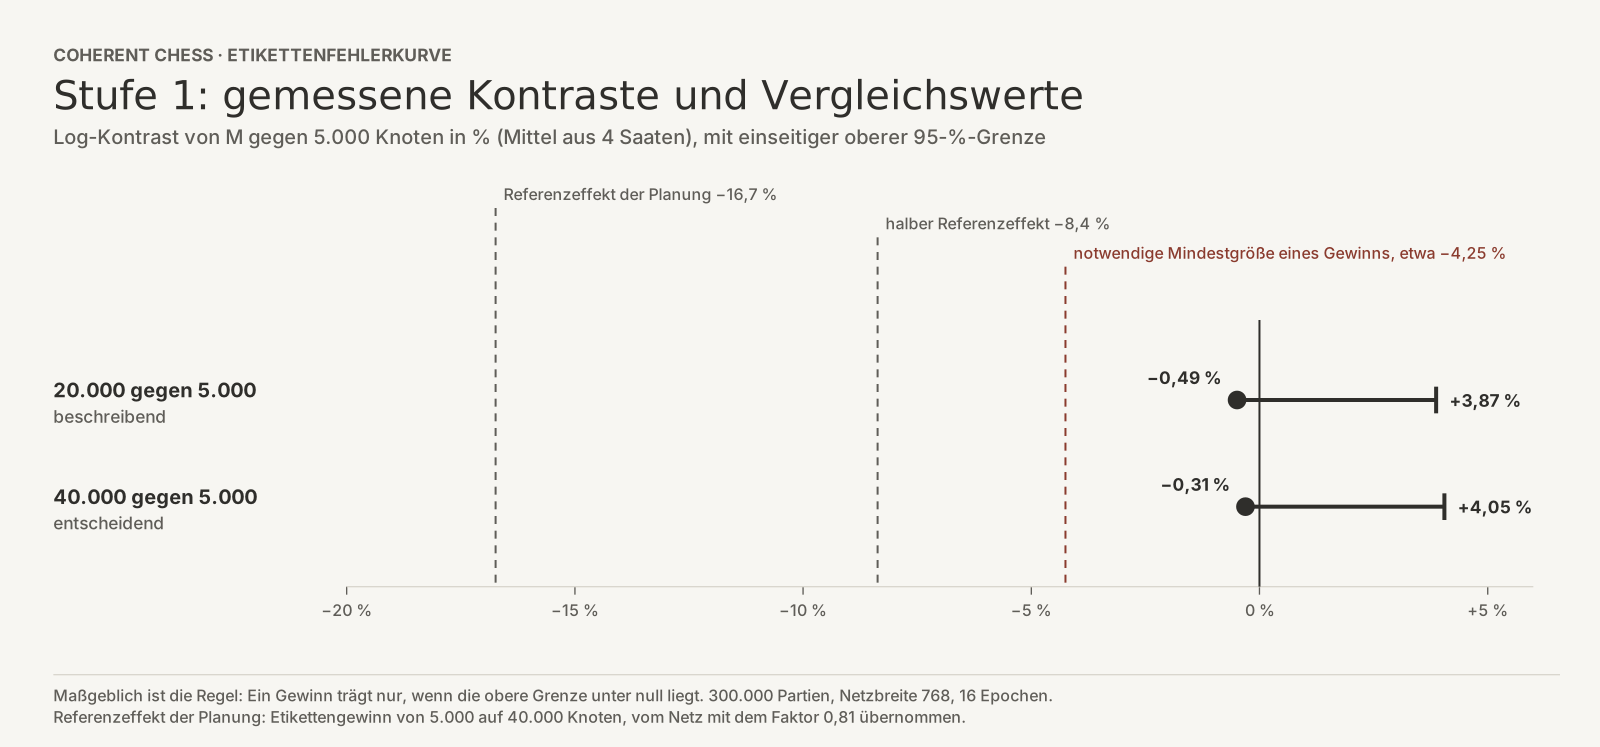
300.000Partien mit20.000oder40.000Knoten neu etikettiert lernten, unterschieden sich im Netzfehler von Netzen aus5.000er-Etiketten um einen Log-Kontrast von−0,49und−0,31%. Nach der vorab festgelegten Regel ist das kein tragfähiger Unterschied; die einseitigen oberen95-%-Grenzen lagen bei+3,87und+4,05%. - Den Partieausgang sagten die Netze aus tieferen Etiketten um
0,0017und0,0023Nats schlechter voraus. Die Messreihe endete plangemäß nach Stufe1. - Der Befund gilt nur für das nachträgliche Umetikettieren bei gleicher Datenmenge und fester Netzbreite
768.
Die Maße
- Etikett: die Bewertung einer Stellung durch eine Suche mit
kKnoten. - Etikettenfehler E(k): das Mittel von
(σ(Etikett/205) − σ(Referenz/205))². σ ist die logistische Funktion; sie macht aus einer Bewertung in Centibauern einen Wert zwischen0und1. Referenz ist eine Suche derselben Engine mit5,12Mio. Knoten und leerem Suchspeicher. - Warm und kalt: Warm läuft die Suche wie in der Datenerzeugung: ein Engineprozess je Partie, die Partie Zug für Zug, der Suchspeicher aus den früheren Zügen bleibt erhalten. Kalt wird der Suchspeicher vor jeder Stellung geleert.
- Netzfehler M: dasselbe Maß für die Bewertung eines trainierten Netzes, auf einem eingefrorenen Messsatz.
- Log-Loss: wie gut eine Bewertung, über eine angepasste Skala in eine Wahrscheinlichkeit umgerechnet, den Ausgang der Partie vorhersagt. Gemessen in Nats; kleiner ist besser.
- Log-Kontrast:
100-mal die Differenz der natürlichen Logarithmen zweier Werte, angegeben in %. Bei kleinen Unterschieden entspricht er etwa der prozentualen Änderung.
Stufe A: Wie genau ist ein Etikett?
Aus zwölf Läufen der eigenen Datenerzeugung wurden 10.008 Partien gezogen, je Partie zwei Stellungen. 20.015 Stellungen waren auswertbar. Jede wurde mit fünf Knotenzahlen warm und kalt neu bewertet und mit der Referenz verglichen. Bei 5.000 Knoten trafen die nachgespielten Zeilen die gelieferten bitgleich.
Der Etikettenfehler sinkt mit der Knotenzahl; kalt ist er 1,27- bis 1,99-mal so groß wie warm. warm, wie in der Datenerzeugung: 625 6,19, 1.250 5,29, 5.000 3,58, 20.000 2,14, 80.000 1,13; kalt, leerer Suchspeicher: 625 7,88, 1.250 6,73, 5.000 5,02, 20.000 3,59, 80.000 2,25.
Knoten k | E warm, Tausendstel | 95-%-Band | E kalt, Tausendstel | kalt/warm | λ*(k) | Suchtiefe warm / kalt, Halbzüge |
|---|---|---|---|---|---|---|
625 | 6,19 | 5,95 – 6,42 | 7,88 | 1,27 | 0,144 | 5,7 / 5,3 |
1.250 | 5,29 | 5,08 – 5,48 | 6,73 | 1,27 | 0,127 | 6,8 / 6,2 |
5.000 | 3,58 | 3,43 – 3,74 | 5,02 | 1,40 | 0,086 | 9,7 / 8,3 |
20.000 | 2,14 | 2,04 – 2,24 | 3,59 | 1,68 | 0,056 | 12,7 / 11,1 |
80.000 | 1,13 | 1,07 – 1,19 | 2,25 | 1,99 | 0,031 | 16,5 / 14,5 |
- Bänder: Bootstrap über ganze Partien mit
2.000Ziehungen. - Verlauf: Über den ganzen Bereich passt
Eproportional zuk^−αmitα = 0,349, Band0,340bis0,360. Auf zwei logarithmischen Achsen wird die Kurve über die gemessenen Abschnitte steiler: Der Betrag der Steigung beträgt0,23(0,19–0,27),0,28(0,26–0,30),0,37(0,35–0,40) und0,46(0,43–0,49). 5.000gegen20.000Knoten: Der Etikettenfehler sinkt um40,3%, Band38,4bis42,2%.- Kalt und warm: Kalt ist der Fehler
1,27- bis1,99-mal so groß wie warm, und die warme Suche erreicht bei gleicher Knotenzahl mehr Tiefe. Ob das echte Genauigkeit ist oder nur ähnlichere Suchbäume, trennt die Messung nicht. - λ(k):* das Gewicht des Partieergebnisses, bei dem eine Mischung aus Etikett und Partieergebnis auf der σ-Skala der Referenz am nächsten käme. Es sinkt mit der Knotenzahl von
0,144auf0,031. Die Netze der Stufe1lernten mit dem Gewicht0,1. - Nachrechnung: Eine unabhängige zweite Implementierung bestätigte alle Entscheidungsgrößen von Stufe A, mit höchstens
0,006% relativer Abweichung.
Wie tief muss die Referenz sein?
Auch die Referenz ist nur eine endliche Suche. Deshalb wurden 2.000 Kontrollstellungen aus 1.000 Partien gegen drei Referenztiefen ausgewertet.
| Referenz, Knoten | α | 95-%-Band | Rückgang von 5.000 auf 20.000 Knoten | 95-%-Band |
|---|---|---|---|---|
1.280.000 | 0,400 | 0,363 – 0,439 | 43,0 % | 34,4 – 50,2 % |
5.120.000 | 0,336 | 0,307 – 0,364 | 38,1 % | 31,7 – 43,8 % |
20.480.000 | 0,279 | 0,256 – 0,302 | 33,5 % | 28,4 – 38,1 % |
- Je tiefer die Referenz, desto kleiner der gemessene Rückgang. Gepaart auf denselben Stellungen ist er gegen
20,48Mio. Knoten um4,6Prozentpunkte kleiner als gegen5,12Mio. Knoten, Band2,8bis6,3. - Die vorab festgelegte Einstufung „mehr“ (untere Grenze des Rückgangs mindestens
10%) hielt bei allen drei Tiefen. - Gegenprobe: Bei
100von100Stellungen lieferte die Referenzsuche mit5,12Mio. Knoten in beiden Läufen dieselbe Bewertung und Tiefe.
Was tiefere Etiketten kosten
200 Partien aus 180 Läufen der Datenerzeugung wurden auf einem voll ausgelasteten Rechner vollständig warm mit 5.000, 20.000 und 40.000 Knoten nachgespielt. Gegen den Durchsatz der Datenerzeugung geeicht ergab sich ein Faktor von 1,243.
Knoten k | Kosten je Partie, relativ zu 5.000 (95-%-Band) | CPU-Sekunden je Partie, geeicht | hochgerechnete Thread-Stunden für 300.000 Partien |
|---|---|---|---|
5.000 | 1 | 0,60 | 49,7 |
20.000 | 3,57 (3,56 – 3,60) | 2,13 | 177,7 |
40.000 | 6,91 (6,86 – 6,95) | 4,12 | 343,4 |
Die fünf teuersten der 200 Partien machten 4,9 % der Kosten aus.
Der Messsatz für Netze
- Umfang:
48.807Partien mit92.314Stellungen, jede mit der kalten Referenz von5,12Mio. Knoten bewertet. - Entdopplung: Stellungen, die auch in Trainingsdaten vorkommen, wurden entfernt; geprüft gegen
600Trainingsläufe mit872Mio. Zeilen,74.934Treffer. Dadurch sank der Anteil der Stellungen mit höchstens neun Steinen von32,5auf26,9%. Alle Werte von M gelten für diese Verteilung. - Haltesatz für den Log-Loss:
11.009Partien; die Skala wird auf1.178Partien angepasst, gemessen auf den übrigen9.831. - Blindheitsprüfung: An
12bestehenden Netzen derselben Bauart ordnete M alle7vorab festgelegten Netzpaare in der erwarteten Reihenfolge. Das zeigt, dass M Unterschiede zwischen Netzen sieht; eine Umrechnung in Spielstärke liefert es nicht.
Vorstufe: Netzfehler und Datenmenge
Vor dem Hauptversuch wurden Netze der Breite 768 mit 5.000er-Etiketten aus 150.000, 300.000 und 1.200.000 Partien trainiert, je 16 Epochen mit dem Ergebnisgewicht 0,1.
Mehr Trainingspartien, kleinerer Netzfehler: von 11,68 auf 8,99 Tausendstel. Netze der Breite 768 mit 5.000er-Etiketten: 150.000 11,68, 300.000 10,64, 1.200.000 8,99.
Partien N | Trainingszeilen je Epoche | Saaten | M, Tausendstel, Mittel | Streuung von ln M zwischen Saaten | Log-Loss, Mittel |
|---|---|---|---|---|---|
150.000 | 10,9 Mio. | 2 | 11,68 | 0,0032 | 0,4082 |
300.000 | 21,7 Mio. | 2 | 10,64 | 0,0050 | 0,4029 |
1.200.000 | 86,9 Mio. | 4 | 8,99 | 0,0064 | 0,3936 |
- Wiederholung: Ein zweiter Lauf mit derselben Saat bei
300.000Partien ergab bitgleiche Netze und denselben Wert von M. - Planung der Stufe
1: Aus der Streuung bei1.200.000Partien setzte die Regel eine Mindeststreuung von0,0372an, das Doppelte des oberen95-%-Rands. Als Referenzeffekt nahm sie an: Übernähme ein Netz den Etikettengewinn von5.000auf40.000Knoten mit dem Faktor0,81, läge der Log-Kontrast von M bei−16,7%. Das ursprüngliche Planungsmodell ergab mit4Saaten beim halben Effekt eine Teststärke von0,989. Die Auswertungsregel wurde danach geändert und gesondert geprüft (nächster Punkt). - Abnahme der Regel: Vor dem ersten Training der Stufe
1wurde die endgültige Regel in einem vorab festgelegten Raster aus1.314synthetischen Prüfzellen simuliert. Ohne echten Effekt ging sie dort in höchstens7,5% der Fälle fälschlich weiter. In den Zellen mit normalverteilter Streuung und dem angesetzten Messfehler erkannte sie den halben Referenzeffekt in mindestens89,2% der Fälle; über alle Zellen mit normalverteilter Streuung deckten ihre Grenzen den wahren Wert in mindestens92,5% der Fälle. Grenzen: Bei stark schiefer Verteilung zwischen den Saaten sinkt die Teststärke beim halben Referenzeffekt auf0,657; wäre die wahre Streuung doppelt so groß wie die Mindeststreuung, gäbe es bei4Saaten keine Schranke der Fehlerrate unter10%. - Folge der Mindeststreuung: Unter dieser Regel muss ein negativer Log-Kontrast dem Betrag nach mindestens etwa
4,25% erreichen. Das ist notwendig, aber nicht hinreichend: Die einseitige obere95-%-Grenze muss unter null liegen.
Stufe 1: Lernt ein Netz aus tieferen Etiketten mehr?
Die ersten 300.000 Trainingspartien wurden mit 5.000, 20.000 und 40.000 Knoten warm neu etikettiert. Partien, Stellungen und Ausgänge blieben dieselben. Je Knotenzahl lernten 4 Netze mit 4 Saaten, in allen drei Armen mit denselben Startgewichten und derselben Batchfolge, je 16 Epochen. Entscheidend war der Vergleich 40.000 gegen 5.000 Knoten; 20.000 Knoten wurde beschreibend ausgewertet.
| Etiketten, Knoten | M, Tausendstel | Log-Kontrast von M gegen 5.000 | Standardfehler nach Regel | obere 95-%-Grenze | Standardfehler beobachtet | Log-Loss | Unterschied (untere Grenze) |
|---|---|---|---|---|---|---|---|
5.000 | 10,654 | – | – | – | – | 0,4026 | – |
20.000 | 10,602 | −0,49 % | 1,87 % | +3,87 % | 0,33 % | 0,4043 | +0,0017 (0,0015) |
40.000 | 10,622 | −0,31 % | 1,88 % | +4,05 % | 0,32 % | 0,4049 | +0,0023 (0,0020) |
- Netzfehler: Tragfähig wäre ein Gewinn nur, wenn die einseitige obere
95-%-Grenze unter null läge. Sie lag beim entscheidenden Vergleich bei+4,05%. - Log-Loss: Bei beiden tieferen Etiketten lag die einseitige untere
95-%-Grenze des Unterschieds über null. Auch das war nach der Regel ein Grund zum Stopp. - Folge: Stopp nach Stufe
1. - Ohne Mindeststreuung: Auch mit dem beobachteten Standardfehler allein läge der Kontrast nur beim
−0,95-Fachen (40.000) und−1,49-Fachen (20.000) seines Standardfehlers. Die gemessenen Kontraste sind um mehr als eine Größenordnung kleiner als der Referenzeffekt der Planung.
Was die Messung nicht zeigt
- Wahrheit: E und M messen die Nähe zu einer tieferen Suche derselben Engine. Blinde Flecken, die Etikettensuche, Netz und Referenz gemeinsam haben, sieht dieses Maß nicht.
- Spielstärke: Keines der Maße ist ein Vergleich in Partien.
- Tiefere Datenerzeugung: Stufe
1hat nur nachträglich umetikettiert. Ob eine Datenerzeugung, die schon beim Spielen tiefer sucht, lehrreichere Stellungen und genauere Partieausgänge liefert, ist nicht gemessen. - Rezept: Der Befund gilt für Netze der Breite
768mit festem Rezept (16Epochen, Ergebnisgewicht0,1, Lernrate0,00025, Batchgröße4.096,300.000Partien), gemessen am Endstand nach der letzten Epoche.
Wie das geprüft wurde
- Quellen: das Datenpaket der Messreihe mit Tabellen, Methodik, Unsicherheiten und einer Quellenliste, die jede Zahl mit Datei und Prüfsumme belegt.
- Paketprüfung: Das Prüfskript des Pakets liest jede Zahl aus ihrer Quelle nach und prüft die Verbote. Für diesen Beitrag lief es erneut:
6.149Prüfungen, alle bestanden. - Nachrechnung: Die Tabellenzeilen dieses Beitrags erzeugt ein eigenes Skript aus den Daten des Pakets und prüft sie gegen beide Sprachfassungen. Steigungen, Kontraste aus den Werten je Saat, Kosten und der Referenzeffekt wurden nachgerechnet.
- Unabhängige Prüfung: Ein Agent einer anderen Modellfamilie prüfte Text, Tabellen und Grafiken in
2Runden gegen das Datenpaket und seine Primärquellen und rechnete Steigungen, Kosten, Planungswerte, Teststärke und die Grenzen der Stufe1selbst nach. Er bestätigte alle Tabellenwerte und benannte Korrekturen, darunter die Herkunft der Teststärke, den Geltungsbereich der Abnahme und die Bezeichnung der Vergleichswerte; sie sind eingearbeitet.