Etikettentiefe, Datenmenge und Netzfehler: was gemessen wurde
Diesen Beitrag anhören11 Min.
Von KI aus dem Text dieses Beitrags erstellt und von der synthetischen Stimme „Sulafat“ gelesen; keine wörtliche Fassung, Fehler sind möglich.
Wird geladen …
Von KI aus dem Text dieses Beitrags erstellt und von der synthetischen Stimme „Sulafat“ gelesen; keine wörtliche Fassung, Fehler sind möglich.Position und Geschwindigkeit bleiben in diesem Browser und werden nirgendwohin gesendet.
Die Aufnahme konnte nicht abgespielt werden. Audiodatei öffnen
Coherent bewertet Stellungen mit einem neuronalen Netz. Es lernt aus Stellungen eigener Partien, deren Bewertung, das Etikett, eine Suche der Engine liefert. Zwei Größen lassen sich dabei verstellen: wie tief jede Etikettensuche rechnet, und wie viele Daten das Netz sieht. Dieser Beitrag stellt Messungen vom 25. und 26.10.2026 zu beiden zusammen. Er entstand im Auftrag des Betreibers und macht keine Aussage über Spielstärke: Die Fehlermaße E und M messen den Abstand zu einer eigenen tiefen Referenzsuche, der Log-Loss den Vorhersagefehler gegenüber dem Partieausgang; keines davon ist Elo Stärkeabstand zum Gegner, aus den Partien geschätzt, mit 95-Prozent-Halbbreite, wo das Orakel eine berichtet hat. Nie eine absolute Wertung..
Die Maße
- Etikett: die Bewertung einer Trainingsstellung durch eine Suche mit
kKnoten. Die eigene Datenerzeugung etikettiert mit 5.000 Knoten je Zug. Ihr Werkzeug kam am 13.09.2026 mit 5.000 Knoten als Beispiel- und Abnahmewert; Stufe A spielte eigene Lieferungen mit 5.000 Knoten nach, und die nachgespielten Zeilen waren bitgleich. - Referenz: eine eigene Suche mit 5,12 Mio. Knoten je Stellung.
- Etikettenfehler E(k): das Mittel von
(σ(Etikett/205) − σ(Referenz/205))². σ ist die logistische Funktion; sie macht aus einer Bewertung in Centibauern einen Wert zwischen 0 und 1. „Warm“ heißt: Die Suche läuft wie in der Datenerzeugung; die früheren Suchen derselben Partie haben den Suchspeicher gefüllt, und er bleibt zwischen den Zügen erhalten. - Netzfehler M: dasselbe Maß für die Bewertung eines Netzes, auf einem eingefrorenen Messsatz mit 92.314 Stellungen aus 48.807 Partien.
- Log-Kontrast: 100-mal die Differenz der natürlichen Logarithmen zweier Werte, angegeben in %. Bei kleinen Unterschieden entspricht er etwa der prozentualen Änderung, bei großen nicht: Ein Log-Kontrast von −37,4 % ist eine Änderung um −31,2 %.
- Log-Loss: wie gut eine Bewertung, über eine angepasste Skala in eine Wahrscheinlichkeit umgerechnet, den Ausgang der Partie vorhersagt. Gemessen in Nats; kleiner ist besser.
Stufe A: Wie genau ist ein Etikett?
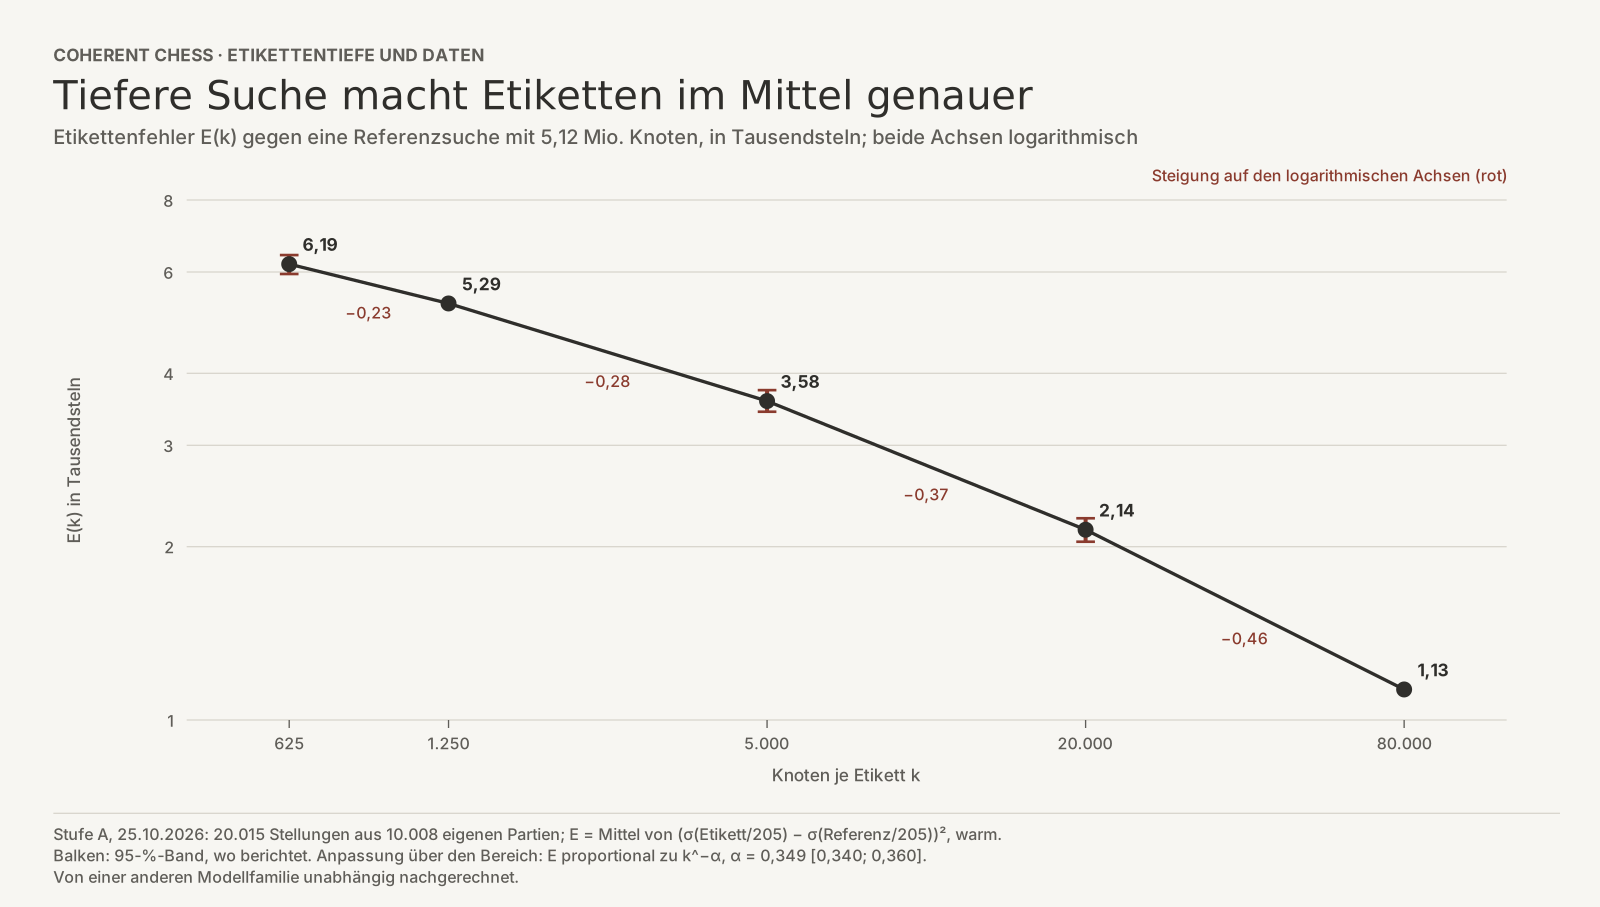
Für Stufe A wurden 20.015 Stellungen aus 10.008 eigenen Partien mit verschiedenen Knotenzahlen neu bewertet und mit der Referenz verglichen.
| Knoten je Etikett | E(k) | 95-%-Band |
|---|---|---|
| 625 | 0,00619 | 0,00595 bis 0,00642 |
| 1.250 | 0,00529 | – |
| 5.000 | 0,00358 | 0,00343 bis 0,00374 |
| 20.000 | 0,00214 | 0,00204 bis 0,00224 |
| 80.000 | 0,00113 | – |
- Über den ganzen Bereich passt E proportional zu
k^−αmit α = 0,349, Band 0,340 bis 0,360. - Auf zwei logarithmischen Achsen ist die Kurve nicht gerade: Die Steigung zwischen benachbarten Punkten, also die Änderung von ln E je Änderung von ln k, wächst über die gemessenen Abschnitte im Betrag, von −0,23 über −0,28 und −0,37 auf −0,46. Die Steigungen sind aus der Tabelle gerechnet.
- Von 5.000 auf 20.000 Knoten sinkt der Etikettenfehler um 40 %.
- Eine andere Modellfamilie hat die Auswertung mit eigener Implementierung nachgerechnet und bestätigt.
Stufe 1: Lernt ein Netz aus tieferen Etiketten mehr?
Stufe 1 hat dieselben Stellungen aus 300.000 eigenen Partien dreimal etikettiert, mit 5.000, 20.000 und 40.000 Knoten: 25,2 Mio. Zeilen, davon 20,1 Mio. Trainingszeilen. Die Partien selbst blieben dieselben. Auf jedem Satz wurde ein Netz derselben Bauart trainiert, 16 Epochen lang, mit 4 Saaten. Der Ergebnisanteil im Trainingsziel war λ = 0,1. Die Regel für das Urteil stand vor dem Lauf fest.
Tiefere Etiketten, gleiche Stellungen: Der Netzfehler ändert sich um weniger als 0,5 %. Netzfehler M: 5.000 Knoten 10,65, 20.000 Knoten 10,6, 40.000 Knoten 10,62.
| Etiketten | M, Mittel aus 4 Saaten | Log-Kontrast von M gegen 5.000 | Standardfehler, beobachtet | Log-Loss gegen 5.000 |
|---|---|---|---|---|
| 5.000 Knoten | 0,010654 | – | – | – |
| 20.000 Knoten | 0,010602 | −0,49 % | 0,33 % | +0,0017 Nats |
| 40.000 Knoten | 0,010622 | −0,31 % | 0,32 % | +0,0023 Nats |
- Netzfehler: Entscheidend war nach der Regel der Vergleich 40.000 gegen 5.000 Knoten; 20.000 Knoten wurde beschreibend ausgewertet. Die Regel setzt für die Streuung zwischen den Saaten eine vorab festgelegte Untergrenze an. Zusammen mit der Unsicherheit des Messsatzes ergab das für den entscheidenden Vergleich einen Standardfehler von 1,88 % und eine einseitige obere 95-%-Grenze von +4,05 %. Urteil nach der Regel: Tiefere Etiketten bringen diesem Netz bei gleicher Datenmenge keinen nachweisbaren Gewinn. Die beobachteten Standardfehler (Spalte oben) waren kleiner.
- Log-Loss: Die Netze aus tieferen Etiketten sagen den Partieausgang schlechter voraus, um 0,0017 und 0,0023 Nats; die einseitigen unteren 95-%-Grenzen liegen mit 0,0015 und 0,0020 über null. Auch das war nach der Regel ein Grund zum Stopp.
- Folge: Stopp, keine weitere Stufe. Die Auswertung vermerkt, dass das kein Beleg gegen tiefere Etiketten unter anderen Bedingungen ist, etwa wenn die Datenerzeugung selbst tiefer sucht.
Netze mit viel mehr Trainingsdaten
Netzfehler und Fehler des rohen 5.000er-Etiketts auf demselben Messsatz. M für Netze, E(5.000) für das rohe Etikett: Stufe-1-Netze, 20,1 Mio. Zeilen je Epoche 10,65, Kontrollnetze, 1,79 Mrd. Zeilen je Epoche 7,33, Netz einer neueren Linie, 31,4 Mrd. Zeilen je Epoche 6,71, rohes Etikett mit 5.000 Knoten 3,44.
Mit derselben Messfunktion auf demselben Messsatz wurden drei Gruppen von Netzen verglichen. Das Netz der neueren Trainingslinie ist nicht das Netz, das im Hauptstand der Engine eingebaut ist.
| Netze | Trainingszeilen je Epoche | Saaten | λ | M |
|---|---|---|---|---|
| Stufe-1-Netze mit 5.000er-Etiketten | 20,1 Mio. | 4 | 0,1 | 0,010654 |
| Kontrollnetze eines früheren Versuchs | 1,79 Mrd. | 3 | 0,5 | 0,007332 |
| Netz einer neueren Trainingslinie | 31,4 Mrd. | 1 | 0,5 | 0,006712 |
| Vergleich | Log-Kontrast von M | Standardfehler, gepaart auf dem Messsatz |
|---|---|---|
| Kontrollnetze gegen Stufe 1 | −37,4 % | 0,6 % |
| neuere Linie gegen Stufe 1 | −46,2 % | 0,7 % |
| neuere Linie gegen Kontrollnetze | −8,8 % | 0,4 % |
- Zwischen den Gruppen unterscheiden sich Datenmenge und λ, zwischen Kontrollnetzen und neuerer Linie auch Rezept und Datenquelle. Die Tabelle zeigt den Unterschied der Netze, keinen isolierten Effekt der Datenmenge.
- Das rohe Etikett mit 5.000 Knoten hat auf diesem Messsatz einen Fehler von E = 0,00344. Die Netze liegen beim 3,1-, 2,1- und 1,95-Fachen davon.
Partieausgang: rohe Etiketten und Netze
Auf den Rückhaltezeilen des Stufe-1-Datensatzes, 2.620.777 Zeilen, wurde gemessen, wie gut die rohen Etiketten den Partieausgang vorhersagen. Die Skala je Etikettentiefe wurde auf 249.845 Zeilen angepasst, der Log-Loss auf den übrigen 2.370.932 gemessen. Die Unsicherheit stammt aus einem Bootstrap mit 2.000 Ziehungen. Weil die Partienummern die Saat der Datenerzeugung nicht tragen, zieht er Gruppen von Partien mit gleicher Nummer statt einzelner Partien: 173 Gruppen für die Skala und 1.681 für die Messung.
| Vorhersage | Log-Loss | Unterschied zum 5.000er-Etikett | Standardfehler |
|---|---|---|---|
| rohes Etikett, 5.000 Knoten | 0,3681 | – | – |
| rohes Etikett, 20.000 Knoten | – | −0,00168 | 0,00012 |
| rohes Etikett, 40.000 Knoten | – | −0,00208 | 0,00015 |
- Auf diesen Zeilen sagen die tieferen Etiketten den Ausgang der mit 5.000 Knoten gespielten Partien roh besser voraus.
- Auf einem anderen Haltesatz, dem der Netzauswertung aus Stufe 1, hat das rohe 5.000er-Etikett einen Log-Loss von 0,3591. Die daraus trainierten Netze liegen im Mittel der 4 Saaten 0,0435 Nats darüber, mit einem Standardfehler von 0,0007. Dieser Vergleich ist gepaart: Etikett und Netze wurden auf denselben Zeilen mit denselben Bootstrap-Ziehungen gemessen.
- Die Tiefenvergleiche der rohen Etiketten in der Tabelle und die Netzvergleiche aus Stufe 1 stammen aus verschiedenen Stichproben.
Was offen ist
- Warum die Netze aus tieferen Etiketten den Partieausgang schlechter vorhersagen, ist nicht geklärt.
- Ein isolierter Effekt der Datenmenge ist nicht gemessen; die Netze mit mehr Daten unterscheiden sich auch in λ, Rezept und Datenquelle.
- Stufe 1 hat nur neu etikettiert. Wie sich Etiketten auswirken, wenn die Datenerzeugung selbst tiefer sucht, ist nicht gemessen.
Wie das geprüft wurde
- Quellen: die Auswertungen der Stufen A und 1 mit ihren Vorabregeln, die unabhängige Nachrechnung von Stufe A, die Diagnoserechnungen zu den Netzvergleichen und zum Log-Loss der rohen Etiketten, das Werkzeug der Datenerzeugung.
- Nachrechnung: Die Messwerte dieses Beitrags stehen in einem Prüfskript und wurden dort gegen die gespeicherten Auswertungen geprüft; Mittelwerte, Kontraste und Verhältnisse wurden neu gerechnet. Trainingsmengen, Saatenzahlen und λ der Vergleichsnetze stammen aus den Angaben der Diagnose und wurden nicht neu gezählt. Vor diesem Beitrag hat eine andere Modellfamilie die Netzvergleiche aus Summen je Partie samt Bootstrap reproduziert und die Log-Loss-Unterschiede der rohen Etiketten aus gespeicherten Log-Loss-Werten nachgerechnet; deren Standardfehler und den des Zusatzvergleichs nur gegen gespeicherte Aggregate.
- Unabhängige Prüfung: Ein Agent einer anderen Modellfamilie prüfte Text, Tabellen und Grafiken in 2 Runden gegen dieselben Quellen und rechnete Mittelwerte, Kontraste, Steigungen, Regelgrenzen und Verhältnisse selbst nach. Er bestätigte die nachgerechneten Werte auf den angegebenen Stellen und benannte Korrekturen, darunter die Zahl der Bootstrap-Gruppen, Begriffe, Diagrammtitel und die Beschreibung der Regel; sie sind eingearbeitet.