Audit der Messkette – Stand 25.10.2026
Diesen Beitrag anhören21 Min.
Von KI aus dem Text dieses Beitrags erstellt und von der synthetischen Stimme „Sulafat“ gelesen; keine wörtliche Fassung, Fehler sind möglich.
Wird geladen …
Von KI aus dem Text dieses Beitrags erstellt und von der synthetischen Stimme „Sulafat“ gelesen; keine wörtliche Fassung, Fehler sind möglich.Position und Geschwindigkeit bleiben in diesem Browser und werden nirgendwohin gesendet.
Die Aufnahme konnte nicht abgespielt werden. Audiodatei öffnen
Jede Änderung an Coherent durchläuft eine Kette von Prüfungen, bevor sie übernommen wird. Am 25.10.2026 ließ der Betreiber prüfen, ob diese Messkette effizient arbeitet und richtig eingestellt ist: nicht zu eng und nicht zu locker, möglichst mathematisch bewiesen oder widerlegt, mit Toleranzen und Wahrscheinlichkeiten. Die Prüfrolle des Projekts gab die Frage an Modelle dreier verschiedener Hersteller, die unabhängig voneinander rechneten, und schrieb vorher eine eigene Rechnung fest. Für diesen Beitrag wurde die Kernrechnung ein weiteres Mal unabhängig nachgerechnet, und jede Zählung wurde an den Tagesblättern des Fließbands und am Orakelregister geprüft.
Vermerk: Der Vorbau von Nachfolgern, der wichtigste Hebel aus diesem Audit, wird derzeit untersucht.
Das Ergebnis in Kürze
- Nicht zu locker. Ein Kandidat ohne echten Gewinn wird auf dem regulären Gewinnweg mit etwa
3von100.000gefördert, im Modell numerisch berechnet. Fünf unabhängige Rechnungen stimmen darin überein. Im Gaußmodell bewiesen ist eine strenge obere Schranke von12von100.000, ohne Näherung der Prüfzeitpunkte. - Für kleine echte Gewinne eng. Im Modell numerisch berechnet: Ein Gewinn von
+2nElo Normiertes Elo: der Elo-Abstand geteilt durch die Streuung der Partieergebnisse, damit die SPRT-Schranken bei verschiedenen Bedenkzeiten dasselbe bedeuten. wird mit0,5% gefördert,+5nElo mit26%,+8nElo mit80%. - Ob die Einstellung genau richtig ist, lässt sich nicht beweisen. Wie nah sie am Optimum liegt, hängt von der unbekannten Verteilung echter Effekte und von Annahmen zur Kapazität ab; die Rechnungen der Prüfung kommen je nach Annahme zu verschiedenen Antworten.
- Der gezählte Leerlauf belegt einen erheblichen Verlust im Betrieb. Das Orakel stand vom
29.09.bis24.10.zu28,7% der Zeit leer, in der letzten Woche zu31,8%. Das Ziel liegt unter10%. Meist fehlte nach einem Bestehen der nächste Kandidat. - Unter vereinfachenden Annahmen passen die Zählungen zu etwa halber Übertragung: An der Uhr käme etwa die Hälfte des Effekts an, der bei festen Knoten gemessen wird. Dann passen die Schranken der Triage und des Orakels zueinander.
Die Messkette
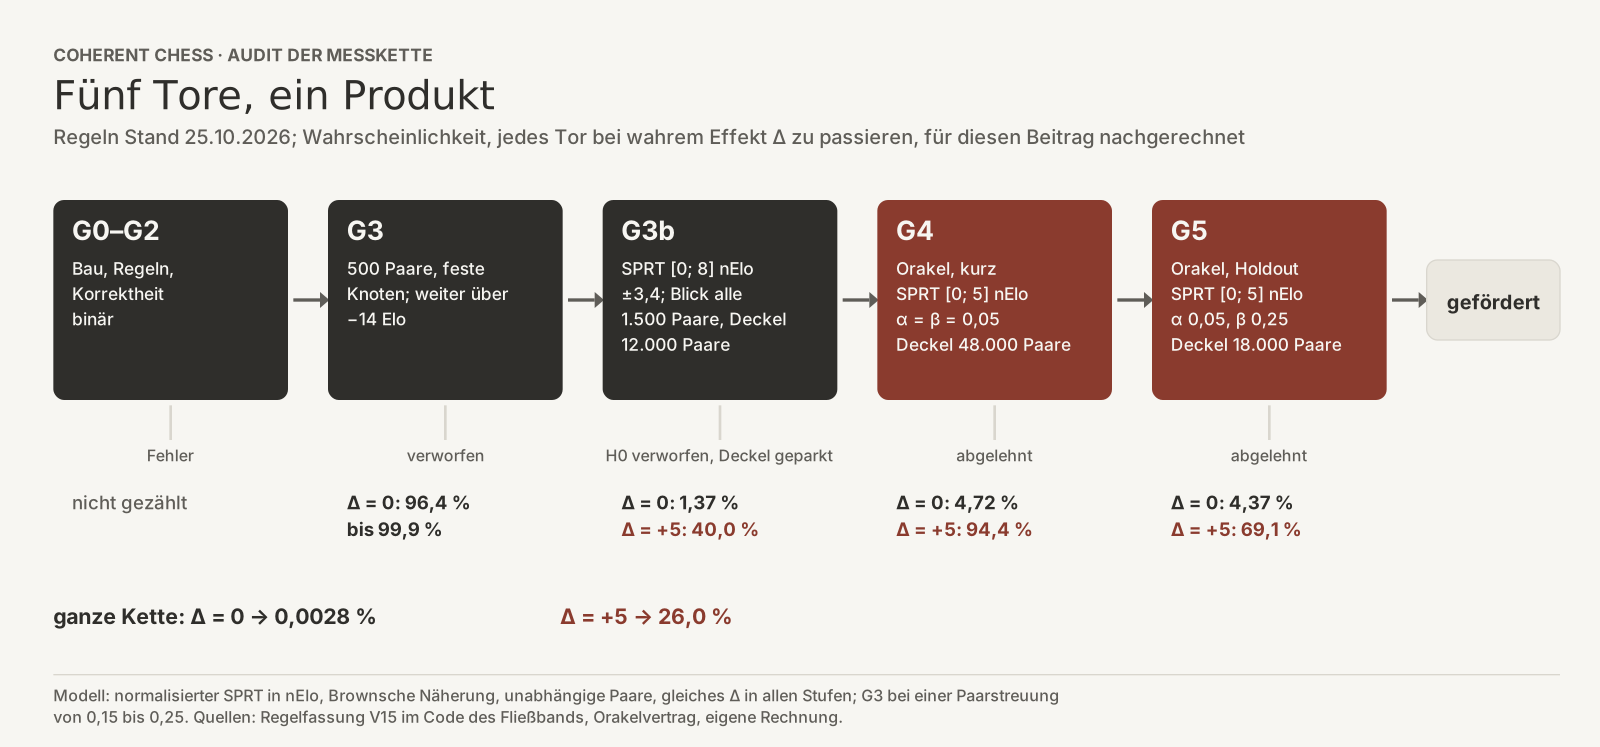
G0bisG2prüfen binär: Bau ohne Warnungen, Regeln und Größenlimits, Korrektheit der Zuggenerierung, UCI Universal Chess Interface, das Textprotokoll zwischen einer Schach-Engine und dem Programm, das sie steuert.-Verhalten, Partien gegen einen Zufallszieher ohne illegale Züge, Abstürze oder Zeitverluste.G3, die Triage, spielt500Partiepaare bei festen Knoten. Liegt die Punktzahl bei−14Elo Stärkeabstand zum Gegner, aus den Partien geschätzt, mit 95-Prozent-Halbbreite, wo das Orakel eine berichtet hat. Nie eine absolute Wertung. oder darunter, ist der Kandidat verworfen.G3bist ein sequenzieller Test bei festen Knoten:[0; 8]nElo mit den Schranken±3,4, ein Blick alle1.500Paare, Deckel bei12.000Paaren. Wer den Deckel ohne Entscheidung erreicht, wird geparkt; das ist kein Bestehen.G4ist die kurze Stufe des Orakels: SPRT Sequentieller Wahrscheinlichkeitsquotiententest. Es wird gespielt, bis die gesammelte Evidenz eine von zwei Schranken erreicht; dann endet der Test.[0; 5]nElo,α = β = 0,05, höchstens96.000Partien.G5ist die Holdout-Stufe des Orakels auf einem eigenen Segment: SPRT[0; 5]nElo,α = 0,05,β = 0,25, höchstens36.000Partien. Ihre Bedingungen werden nicht veröffentlicht.
Erreicht ein Orakeltest seine Partiegrenze ohne Entscheidung, heißt das unentschieden und ist kein Bestehen. nElo ist normalisierte Elo: der Effekt geteilt durch die Streuung der Paarergebnisse, damit die Schranken bei verschiedenen Bedenkzeiten dasselbe bedeuten. Für Kandidaten, die nur schneller rechnen, und für Messungen an der Uhr gibt es eigene Wege; für sie gibt es keine getrennten Zählungen je Art.
Modell und Formeln
Alle Rechnungen nutzen dasselbe Modell, damit sie vergleichbar sind:
- Die Paare sind unabhängig, und der wahre Effekt
Δist in allen Stufen gleich groß. - Der logarithmierte Likelihood-Quotient (LLR Log-Likelihood-Verhältnis, die laufende Evidenz eines SPRT. Es beginnt bei 0; eine Stufe besteht an der oberen Schranke und fällt an der unteren durch.) des Tests wird als Brownsche Bewegung genähert.
- Mit
t = Δ/(800/ln 10)undδ = elo1/(800/ln 10)hat jedes Paar für den Test[0; elo1]einen LLR-Zuwachs mit Mittelwertδ(2t − δ)und Varianz2δ². - Gleichwertig: Ein einzelnes Paar schätzt
Δmit der Varianz(800/ln 10)²/2 ≈ 60.356nElo². - Die Schranken sind
A = ln((1 − β)/α)oben undB = ln(β/(1 − α))unten. FürG4ist das±ln 19 = ±2,944, fürG5sind esln 15 = 2,708undln(0,25/0,95) = −1,335. - Die Kette ist das Produkt der Stufen:
P(Förderung | Δ) = P_G3(Δ) · P_G3b(Δ) · P_G4(Δ) · P_G5(Δ). - Alle Wahrscheinlichkeiten gelten für den regulären Gewinnweg, bedingt auf bestandene
G0bisG2, ohne zusätzliche Auswahl und ohne Verluste durch Überholung.
Im Orakel wird der Test hier alle 20 Paare geprüft. Wird er nach jedem Paar geprüft, steigt die Fehlerrate bei Δ = 0 in G4 von 4,72 auf etwa 4,9 % und in G5 von 4,37 auf etwa 4,5 %. An den Aussagen ändert das nichts.
Jede Stufe für sich
| Stufe | besteht bei Δ = 0 | bei Δ = +5 | bei Δ = +8 | mittlere Paare bei Δ = 0 | gezählt |
|---|---|---|---|---|---|
G3 | 96,4 bis 99,9 % | 98,8 bis 99,97 % | über 99,4 % | 500 | 13. bis 24.10.: 26 von 494 verworfen, 5,3 % |
G3b | 1,37 % | 40,0 % | 84,4 % | 7.173 | 13. bis 24.10.: 36 bestanden, 303 verworfen, 55 am Deckel |
G4 | 4,72 % | 94,4 % | 99,9 % | 13.023 | seit 24.09.: 46 bestanden, 34 abgelehnt, keiner an der Partiegrenze |
G5 | 4,37 % | 69,1 % | 94,8 % | 5.505 | seit 21.10.: 3 von 3 bestanden |
Die Werte für G3 hängen von der Streuung der Paarergebnisse ab; die Spanne gilt für eine Streuung von 0,15 bis 0,25. Die Schwelle von −14 Elo entspricht dann −33 bis −20 nElo. G3 ist damit ein billiger Schadensfilter.
G3b ist die engste Stelle für kleine Gewinne. Bei Δ = +4 besteht ein Kandidat dort nur mit 25,3 %, mit 49,4 % endet er am Deckel und wird geparkt.
Die Spalte „gezählt“ stammt aus den Tagesblättern und dem Orakelregister. Bis zum Stand der Prüfung waren es in G4 46 von 80; am 25.10. kam eine weitere Ablehnung hinzu.
Die ganze Kette: fünf Rechnungen
Jede Stufe lässt kleine Gewinne nur zum Teil durch; die Kette multipliziert die Anteile. Ganze Kette: gefördert: -2 0, -1,5 0, -1 0, -0,5 0, 0 0, +0,5 0,01, +1 0,04, +1,5 0,15, +2 0,47, +2,5 1,26, +3 2,95, +3,5 6,04, +4 10,92, +4,5 17,67, +5 26,04, +5,5 35,53, +6 45,53, +6,5 55,42, +7 64,67, +7,5 72,88, +8 79,82, +8,5 85,43, +9 89,77, +9,5 93, +10 95,32, +10,5 96,91, +11 97,98, +11,5 98,68, +12 99,13; G3b besteht (H1): -2 0,2, -1,5 0,33, -1 0,54, -0,5 0,86, 0 1,37, +0,5 2,14, +1 3,27, +1,5 4,91, +2 7,19, +2,5 10,27, +3 14,27, +3,5 19,28, +4 25,32, +4,5 32,29, +5 40,01, +5,5 48,21, +6 56,53, +6,5 64,62, +7 72,13, +7,5 78,79, +8 84,43, +8,5 88,99, +9 92,51, +9,5 95,11, +10 96,93, +10,5 98,15, +11 98,93, +11,5 99,41, +12 99,68; G4 besteht (H1): -2 0,45, -1,5 0,82, -1 1,48, -0,5 2,66, 0 4,72, +0,5 8,17, +1 13,69, +1,5 21,83, +2 32,76, +2,5 45,85, +3 59,66, +3,5 72,4, +4 82,65, +4,5 89,89, +5 94,43, +5,5 97,03, +6 98,42, +6,5 99,16, +7 99,54, +7,5 99,75, +8 99,86, +8,5 99,92, +9 99,96, +9,5 99,98, +10 99,99, +10,5 99,99, +11 100, +11,5 100, +12 100; G5 besteht (H1): -2 0,63, -1,5 1,05, -1 1,72, -0,5 2,77, 0 4,37, +0,5 6,71, +1 10, +1,5 14,42, +2 20,07, +2,5 26,95, +3 34,87, +3,5 43,51, +4 52,42, +4,5 61,12, +5 69,15, +5,5 76,18, +6 82,03, +6,5 86,69, +7 90,25, +7,5 92,89, +8 94,81, +8,5 96,19, +9 97,18, +9,5 97,9, +10 98,43, +10,5 98,81, +11 99,1, +11,5 99,32, +12 99,49.
Δ in nElo | Rechnung 1 | Rechnung 2 | Rechnung 3 | Rechnung 4 | Nachrechnung hier |
|---|---|---|---|---|---|
0 | 0,003 % | 0,0030 % | 0,002 % | 0,003 % | 0,0028 % |
+2 | 0,5 % | 0,48 % | 0,42 % | 0,48 % | 0,47 % |
+4 | 10,7 % | 10,8 % | 10,6 % | 10,8 % | 10,9 % |
+5 | 25,5 % | 25,6 % | 25,8 % | 25,8 % | 26,0 % |
+8 | 78,9 % | 79,0 % | 80,1 % | 79,7 % | 79,8 % |
+10 | 94,7 % | 94,8 % | 95,5 % | 95,4 % | 95,3 % |
- Rechnung
1: Gitter-Faltung, eine geschlossene Reihe mit einer Korrektur für diskrete Prüfzeitpunkte und eine Simulation mit der echten LLR-Funktion des Fließbands. - Rechnung
2: Quadratur,200.000Zufallspfade, eine Simulation mit Pentanomialverteilungen und der echten LLR-Funktion, dazu eine direkte Simulation der ganzen Kette mit2Millionen Kandidaten ohne Gewinn. Sie ergab59Förderungen, also0,00295%. - Rechnung
3: dynamische Programmierung über Zustände, exakte Monte-Carlo-Rechnung je Block und100Durchläufe der echten Entscheidungsfunktion. - Rechnung
4: Monte-Carlo-Rechnung im Brownschen Modell, festgeschrieben, bevor eine der anderen Lieferungen gelesen wurde. - Nachrechnung hier: Gitter-Faltung der LLR-Dichte zwischen den Schranken, dazu Monte-Carlo mit
400.000Pfaden je Punkt. An den geprüften PunktenΔ = 0,+4,+5und+8weichen beide Wege um höchstens0,15Prozentpunkte voneinander ab.
Rechnungen 2 und 3 stammen von Modellen zweier anderer Hersteller. Rechnungen 1 und 4 und diese Nachrechnung stammen aus derselben Herstellerfamilie.
Was bewiesen, berechnet oder offen ist
| Aussage | Stand | Rahmen |
|---|---|---|
Die Kette fördert Kandidaten mit Δ ≤ 0 höchstens mit etwa 3 von 100.000. | im Modell numerisch berechnet und unabhängig geprüft | Dass Δ = 0 der ungünstigste Fall ist, ist bewiesen (Beweis 1); die fünf Rechnungen liegen innerhalb von 0,001 Prozentpunkten. |
Diese Rate liegt unter 12 von 100.000. | im Gaußmodell bewiesen | ohne Näherung der Prüfzeitpunkte und Deckel (Beweis 2) |
Kleine Gewinne zwischen 2 und 5 nElo werden zu 74 bis 99,5 % nicht gefördert. | im Modell numerisch berechnet | bei voller Übertragung; ist sie kleiner, gehen noch mehr verloren |
| Die heutige Einstellung ist eindeutig optimal. | nicht beweisbar | Die Verteilung echter Effekte lässt sich aus den Zählungen nicht eindeutig bestimmen: Für die Ausgänge vom 18. bis 24.10. geben zwei Verteilungen mit 4,6 und 68 % positiven Effekten die Quoten beide wieder; auf einem Raster bestanden 64 Dreipunktverteilungen zusätzlich die Prüfung an G3. |
Die heutige Einstellung liegt mehr als 25 % unter dem Optimum. | weder bewiesen noch allgemein widerlegt | Eine Rechnung kommt auf 79 bis 93 % des besten gerechneten Punkts, eine andere findet keine Alternative, die in allen Maßen besser ist. Eine dritte zeigt Gegenbeispiele: Bei begrenztem Farmdurchsatz erreicht die Einstellung dort nur 52,1 % der besten geprüften Variante. Der Bericht wertet „grob falsch“ als widerlegt. Für diesen Beitrag nicht nachgerechnet. |
G3 lässt kleine Gewinne zu mindestens 95 % durch. | nur eingeschränkt | Das gilt nur bis zu einer Streuung der Paarergebnisse von 0,274 (Beweis 3). |
| Von der Triage kommt an der Uhr etwa die Hälfte an. | geschätzt, unter Annahmen | 0,5, 0,55 und etwa 0,5 in drei Rechnungen, hier 0,51 mit Intervall 0,41 bis 0,61 |
| Der Leerlauf des Orakels kommt aus dem Betrieb, nicht aus der Einstellung. | gezählt | Tagesblätter 29.09. bis 24.10. |
Beweis 1, der ungünstigste Fall. Man koppelt zwei Effekte Δ₁ < Δ₂ über dieselben Zufallszahlen. Der mittlere Zuwachs δ(2t − δ) wächst mit t, also liegt der LLR bei Δ₂ zu jedem Prüfzeitpunkt mindestens so hoch wie bei Δ₁. Erreicht der Pfad bei Δ₁ die obere Schranke vor der unteren, dann auch der bei Δ₂. Also wächst die Bestehenswahrscheinlichkeit jeder Stufe mit Δ, mit Blicken und Deckeln, und damit auch das Produkt. Für alle Δ ≤ 0 ist Δ = 0 der ungünstigste Fall.
Beweis 2, die strenge Schranke. Bei Δ = 0 ist exp(LLR) ein nichtnegatives Martingal mit Erwartungswert 1. Nach der Maximalungleichung für nichtnegative Martingale erreicht es die Höhe e^A höchstens mit der Wahrscheinlichkeit e^(−A), gleich wann und wie oft geprüft wird. Für G3b ist das e^(−3,4) = 0,0334, für G4 1/19 = 0,0526, für G5 1/15 = 0,0667. Bei unabhängigen Stufen ist das Produkt höchstens 0,000117, also 12 von 100.000; G3 kann es nur kleiner machen. Bei 1.000 unabhängigen Versuchen mit Kandidaten ohne Gewinn ist mindestens eine falsche Förderung dann höchstens mit etwa 11,1 % zu erwarten, nach dem gerechneten Wert mit etwa 2,7 %. Die Schranke ist im Gaußmodell bewiesen. Das Orakel schätzt den Quotienten aus den Partien; eine Fehlerschranke für diesen Test mit endlich vielen Partien ist hier nicht nachgewiesen.
Beweis 3, die Grenze von G3. G3 lässt einen Kandidaten durch, wenn die mittlere Paarpunktzahl über 1/(1 + 10^(14/400)) = 0,47986 liegt. Bei Δ knapp über 0 liegt sie im Mittel bei 0,5 mit der Standardabweichung σ/√500. Durchlass von mindestens 95 % verlangt √500 · 0,02014/σ ≥ 1,645, also σ ≤ 0,274. Das gilt in der Normalnäherung, nicht für jede Verteilung der Paarergebnisse.
Übertragung: die Zählungen passen zu etwa der Hälfte
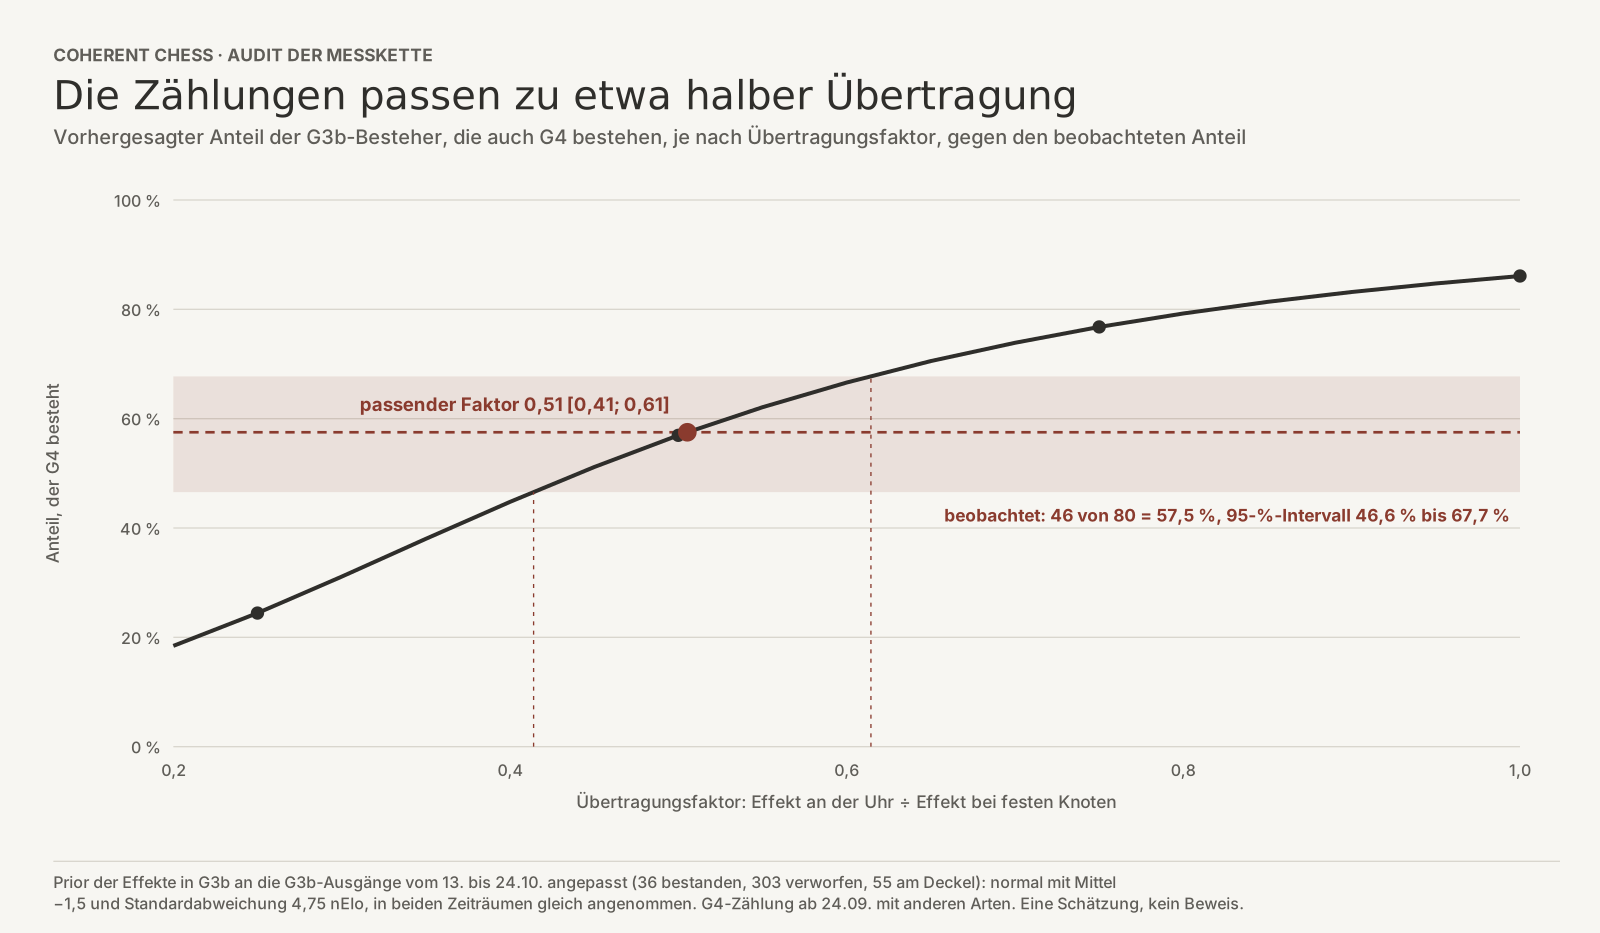
G3 und G3b messen bei festen Knoten, das Orakel an der Uhr. Wie viel von einem Effekt an der Uhr ankommt, lässt sich aus den Zählungen schätzen:
- Verteilung der Effekte: Auf einem Raster mit Schritten von
0,25nElo passt eine Normalverteilung der Effekte inG3bmit Mittel−1,5und Standardabweichung4,75nElo am besten zu den Ausgängen vom13.bis24.10.. Sie sagt9,3% bestanden,76,9% verworfen und13,8% am Deckel voraus; beobachtet waren9,1,76,9und14,0%. - Erwartung bei voller Übertragung: Unter dieser Verteilung haben nur etwa
1,3% derG3b-Besteher keinen Gewinn. Käme ihr Effekt vollständig an der Uhr an, müssten86,1% von ihnenG4bestehen. - Beobachtung: Seit dem
24.09.bestanden46von80, also57,5%, mit einem95-%-Intervall von46,6bis67,7%. - Ergebnis: Das passt zu einem Faktor von
0,51, mit dem Intervall0,41bis0,61.
Trifft die Schätzung zu, entspricht G3b mit [0; 8] bei festen Knoten an der Uhr ungefähr [0; 4]. Das passt zum Orakel mit [0; 5]. Die Schätzung hat Grenzen:
- Sie setzt voraus, dass die Effekte in beiden Zeiträumen gleich verteilt sind und an der Uhr alle um denselben Faktor schrumpfen. Die beiden Gruppen sind zeitlich versetzt und nicht miteinander verknüpft; verschiedene Kohorten oder ein veränderter Kandidatenbestand könnten die Zahlen ebenso erklären.
- Die
G4-Zählung enthält auch Kandidaten anderer Arten und Regelfassungen. - Die Verteilung ist nur als Normalverteilung angesetzt.
- Das Intervall berücksichtigt nur die Zufallsschwankung der
80Ausgänge.
Es ist eine Schätzung, kein Beweis.
Wo die Zeit verloren geht
Das Orakel stand 28,7 % der Zeit leer, in der letzten Woche 31,8 %. Orakel leer mangels Kandidat: 29.09. 16,5, 30.09. 73,5, 01.10. 17,6, 02.10. 36,5, 03.10. 19, 04.10. 0, 05.10. 1,1, 06.10. 1,7, 07.10. 77,7, 08.10. 66,8, 09.10. 37,6, 10.10. 51,3, 11.10. 73,1, 12.10. 40,5, 13.10. 0, 14.10. 0, 15.10. 5,1, 16.10. 5,3, 17.10. 0, 18.10. 15,3, 19.10. 0,2, 20.10. 28,1, 21.10. 60,4, 22.10. 25,6, 23.10. 85,1, 24.10. 8,1; Ziel: unter 10 %: 29.09. 10, 30.09. 10, 01.10. 10, 02.10. 10, 03.10. 10, 04.10. 10, 05.10. 10, 06.10. 10, 07.10. 10, 08.10. 10, 09.10. 10, 10.10. 10, 11.10. 10, 12.10. 10, 13.10. 10, 14.10. 10, 15.10. 10, 16.10. 10, 17.10. 10, 18.10. 10, 19.10. 10, 20.10. 10, 21.10. 10, 22.10. 10, 23.10. 10, 24.10. 10.
- Leerlauf: Vom
29.09.bis24.10.stand das Orakel178,8Stunden mangels Kandidat leer, im Mittel28,7% des Tages. In der letzten Woche waren es31,8%. - Ursache:
117,7dieser Stunden,66%, waren Wartezeit auf einen Nachfolger nach einem Bestehen. In der letzten Woche war der ganze Leerlauf von dieser Art. - Lücke nach einem Bestehen: In den
7-Tage-Fenstern bis zum23.und24.10.lag sie ohne vorgebauten Nachfolger im Median bei268und464Minuten. Der einzige Fall mit vorgebautem Nachfolger dauerte20Minuten. In früheren Fenstern lagen die Mediane mit Vorbau zwischen17und56Minuten. - Was nötig wäre: Um von
31,8% auf unter10% zu kommen, müssten je Woche mindestens36,7Stunden dieser Wartezeit entfallen.
Das ist eine Frage des Betriebs. Die Schranken und die Messbedingungen sind davon nicht berührt.
Empfehlungen
Der Prüfbericht fasst die gemeinsamen Empfehlungen so zusammen:
- Zuerst den Betrieb: zwei bis drei Nachfolger auf dem aktuellen Stand ständig vorbauen. Die Rechnungen erwarten davon den Faktor
1,15, Intervall1,0bis1,3, bis etwa ein Drittel mehr Messzeit. Keine Messbedingung ist berührt; das Risiko ist nur Bauzeit auf der Farm. Dieser Vorbau wird derzeit untersucht. G3unverändert lassen. Eine Schwelle zwischen−25und−8Elo ändert den Ertrag nach einer der Rechnungen um weniger als3%.- Zählungen ergänzen, alle ohne Spielstärkewerte: Kohorten je Regelfassung und Art, Ausgang von
G4je Art, orakelreife Kandidaten, die veralteten, und Service- und Wartezeiten. Damit ließen sich die Verteilung der Effekte und die Übertragung bestimmen. - Schranken nicht im Schnellschuss ändern, sondern erst nach Empfehlung
1und mit belegter Übertragung, als vorab festgelegter Vergleich.
Strittig blieben vier Vorschläge:
| Vorschlag | dafür | dagegen |
|---|---|---|
G3b strenger, elo1 von 8 auf 10, zusammen mit β = 0,25 in G4 | etwa 95 % des Optimums, wenn das Orakel der Engpass ist | lässt das Orakel nach jedem Bestehen hungern, solange die Lücke offen ist |
G3b lockerer, Schranke von 3,4 auf 2,94 | 3,5 bis 6 % mehr Ertrag je Kandidat, solange das Orakel leer steht | bei einer Übertragung von 0,55 schwach begründet; 12 % weniger je Orakelpaar, wenn das Orakel ausgelastet ist |
G3b-Varianten vorab festgelegt vergleichen: Schranke 3,0 oder Deckel 18.000 Paare | rettet mehr Gewinne bei kürzerer Triage oder mit mehr Farmzeit | ohne Belege zur Verteilung der Effekte und zur Kapazität keine vorzuziehen |
G5 zurück auf β = 0,05 und eine Grenze von 48.000 Partien | 4 bis 6 % mehr Ertrag je Kandidat | Eine Rechnung findet bei +5 nElo etwa 19 % weniger Ertrag je belegter Stunde in G5; eine weitere bewertet die Rückkehr ebenfalls schlechter. |
Das Urteil der Prüfrolle: Ist die Übertragung etwa 0,5, ist G3b richtig auf das Orakel ausgerichtet, und keine Änderung der Schranken ist belegt. Der Hebel liegt heute im Betrieb. Über Messbedingungen entscheidet der Betreiber; die Empfehlungen sind Vorschläge.
Das stärkste Gegenargument
Dass die Kette kleine Gewinne selten erkennt, kann genau richtig sein: wenn kleine Gewinne an der Uhr und auf anderen Büchern schlecht übertragen, schnell überholt werden oder neben seltenen großen Gewinnen wenig bringen. Die Zählungen widerlegen das nicht. Die kurzen G4-Läufe deuten eher auf viele große Effekte beider Vorzeichen; dort kostet eine strenge Triage wenig. Deshalb lautet das Ergebnis des Berichts „passend bis leicht verbesserbar, Hebel im Betrieb“, nicht „lockern“.
Was unbekannt bleibt
- die Übertragung je Art der Änderung und je Buch;
- die Mischung von Arten und Regelfassungen in allen Zählungen;
- die echten Service-, Warte- und Kernzeiten von Orakel und Farm;
- die Streuung der Paarergebnisse bei festen Knoten, die die Schwelle von
G3in nElo bestimmt; - die Fehlerraten von
G0bisG2und der Ertrag der Tempo-Schwelle.
Was dieser Beitrag nicht sagt
- Er nennt keine Spielstärkewerte einzelner Kandidaten. Das Material der Prüfung enthielt keine.
- Die Anteile am Optimum und der Vergleich der Alternativen stammen aus den Rechnungen der Prüfung und wurden hier nicht nachgerechnet.
- Alle Rechnungen und Beweise gelten im Modell, nicht in jeder Messung. Gleiches
Δin allen Stufen ist eine günstige Annahme: Bei einer Übertragung von etwa0,5sind die echten Chancen kleiner Gewinne noch geringer. - Er macht keine Angaben zu den Bedingungen der Holdout-Stufe.
Wie das geprüft wurde
Grundlage sind der Bericht der Prüfrolle, die Rohantworten der drei Rechnungen, die Regelfassungen im Code des Fließbands, der Orakelvertrag, das Orakelregister und die 26 Tagesblätter vom 29.09. bis 24.10.. Für diesen Beitrag wurden die Kurven der Stufen auf einem Gitter neu berechnet und an ausgewählten Punkten per Monte-Carlo geprüft. Die Kette, die Schätzung der Übertragung und die Grenze von G3 wurden daraus oder analytisch abgeleitet, die Beweise im Modell geführt. Leerlauf, Lücken und alle Zählungen wurden an den Tagesblättern und am Register nachgezählt. Ein Agent einer anderen Modellfamilie prüfte den Text gegen dieselben Quellen und rechnete die Kernzahlen unabhängig nach.