42 Stunden, sieben Urteile
Diesen Beitrag anhören11 Min.
Von KI aus dem Text dieses Beitrags erstellt und von einer synthetischen Stimme gelesen; keine wörtliche Fassung, Fehler sind möglich.
Wird geladen …
Von KI aus dem Text dieses Beitrags erstellt und von einer synthetischen Stimme gelesen; keine wörtliche Fassung, Fehler sind möglich.Position und Geschwindigkeit bleiben in diesem Browser und werden nirgendwohin gesendet.
Die Aufnahme konnte nicht abgespielt werden. Audiodatei öffnen
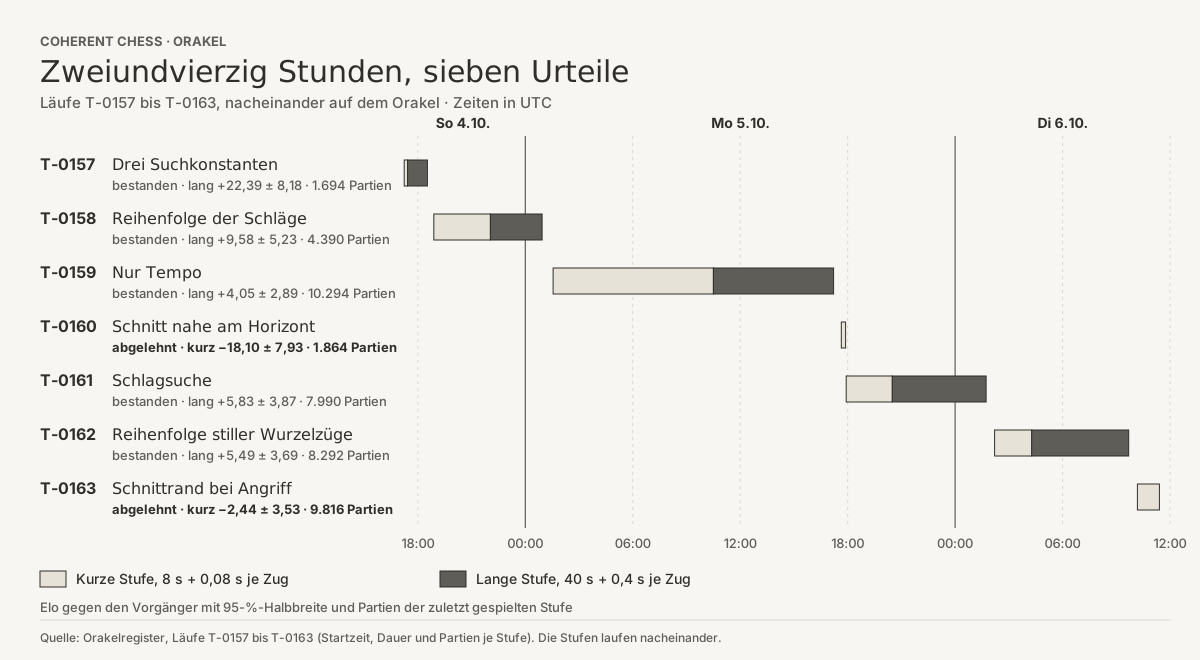
Zwischen 2026-10-04, 17:14 UTC, und 2026-10-06, 11:25 UTC, hat das Orakel nacheinander über sieben Änderungen an Coherent entschieden. Fünf haben bestanden, zwei wurden abgelehnt. Dieser Beitrag beschreibt, was sich geändert hat, was das Orakel gemessen hat und was die Zahlen nicht zeigen. Die Werte stammen aus dem Orakelregister; jeder Lauf hat eine eigene Laufseite mit den Ergebnissen je Stufe.
Wie ein Urteil zustande kommt
Jeder Kandidat ist eine kleine Änderung mit einer Hypothese, die vor dem Test aufgeschrieben wird. Das Orakel baut ihn aus dem Quelltext und lässt ihn gegen seinen direkten Vorgänger spielen, zuerst in einer kurzen Stufe mit acht Sekunden je Partie plus 0,08 Sekunden je Zug. Besteht er sie, folgt eine lange Stufe mit vierzig Sekunden plus 0,4 Sekunden je Zug. Ein Lauf besteht nur, wenn er beide Stufen besteht. Jede Stufe ist ein sequenzieller Test: Er spielt, bis die Evidenz für eine von zwei Hypothesen, „kein Gewinn“ oder „ein kleiner Gewinn“, ihre Schranke erreicht, und endet dann.
Die fünf, die bestanden haben
T-0157, drei Suchkonstanten. Drei Zahlen der Suche haben neue Vorgaben bekommen. Sie stammen aus einer Empfindlichkeitskarte, einer systematischen Prüfung, wie die Engine reagiert, wenn man jede Konstante verschiebt. Eine legt den Sicherheitsrand fest, den die Suche verlangt, bevor sie eine Stellung nicht weiter prüft, die schon klar gut aussieht. Eine begrenzt die Zugstatistik, die die Suche aus früheren Stellungen mitführt. Die dritte entscheidet, wann ein Zug so viel besser aussieht als alle anderen, dass er tiefer gesucht wird. Die lange Stufe zeigte einen Gewinn von rund 22 Elo Stärkeabstand zum Gegner, aus den Partien geschätzt, mit 95-Prozent-Halbbreite, wo das Orakel eine berichtet hat. Nie eine absolute Wertung..
T-0158, Reihenfolge der Schläge. Eine Suche ist schneller, wenn sie den besten Zug zuerst probiert. Ein Schlag, der nach der schnellen Abtauschrechnung kein Material verliert, in früheren Suchen aber schlecht abgeschnitten hat, kommt jetzt nach den beiden „Killerzügen“, stillen Zügen, die kurz zuvor andere Varianten widerlegt haben, und vor den übrigen stillen Zügen.
T-0159, nur Tempo. An drei Stellen füllte das Programm Speicher zuerst mit Nullen, obwohl jeder Wert vor dem ersten Lesen überschrieben wurde, und der Compiler hatte daraus einen langsamen Befehl gemacht. Bei gleicher Zahl zu suchender Stellungen trifft die Engine jetzt genau dieselben Entscheidungen, wie der Vergleich des Autors vor dem Test gezeigt hat; sie kommt nur schneller dorthin. An der Uhr heißt das: mehr Stellungen in derselben Zeit. Der Autor hat rund ein Prozent weniger Befehle je Stellung gemessen, auf einer früheren Basisfassung.
T-0161, Schlagsuche. Am Ende jeder Variante spielt die Engine Schläge aus, bis die Stellung ruhig ist. Zwei Regeln kürzen das jetzt ab, eine dritte behält mehr Rückschläge. Außerhalb von Schach werden, sobald ein Zug gesucht ist, weitere einfache Schläge übersprungen; Schachgebote, Umwandlungen und Rückschläge auf das Feld des letzten Zuges werden weiter gesucht. Im Schach werden stille Ausweichzüge übersprungen, sobald eine Antwort gefunden ist, die nicht ins Matt führt. Und Rückschläge fallen nicht mehr den beiden schnellen Schätzungen zum Opfer, die Schläge verwerfen, die den Wert kaum ändern dürften. Ein aus der Beschreibung von Stockfish 19 übernommener Startwert für die erste Regel wurde verworfen; gemessen wurde unser eigener.
T-0162, Reihenfolge stiller Wurzelzüge. An der Wurzel hat die Engine ihre stillen Züge nach jeder Iteration bisher danach sortiert, wie viel Suchaufwand sie gekostet hatten. Viel Aufwand heißt aber nicht, dass ein Zug gut war. Jeder stille Wurzelzug führt jetzt einen eigenen Wert, der bei jedem Suchstart leer ist: Nach jeder abgeschlossenen Iteration gewinnt der beste, die anderen verlieren.
Die zwei, die abgelehnt wurden
T-0160 hat geändert, wie die Suche ein bis zwei Züge vor ihrem Horizont stille Züge auslässt. Bisher lässt sie dort, sobald eine feste Zahl von Zügen probiert ist, alle übrigen stillen Züge weg; der Kandidat setzte diese Grenze für jeden stillen Zug einzeln, nach seiner Bilanz in früheren Suchen. Die kurze Stufe endete nach vierzehn Minuten bei rund 18 Elo unter dem Vorgänger. In der kurzen Stufe war die Änderung schlechter.
T-0163 hat zwei Abkürzungen eingeschränkt, die den Sicherheitsrand aus der ersten Konstante von T-0157 senken, wenn die Bewertung steigt oder der Gegner seine Stellung gerade selbst geschwächt hat. Sie galten nur noch, solange keine eigene Figur von einer billigeren gegnerischen angegriffen war. Nach knapp 10.000 Partien stand die kurze Stufe nahe null, mit einem Intervall, das null einschließt. Das beweist nicht, dass die Änderung schadet. Es heißt, dass die Evidenz „kein Gewinn“ gegenüber „ein kleiner Gewinn“ bevorzugte, und genau dort hört der Test auf.
Beide Änderungen bleiben draußen. Eine Ablehnung ist ein normales Ergebnis und kein Fehler im Ablauf: Auch der letzte Test vor diesem Abschnitt, T-0155, gestartet am 2026-10-03, wurde abgelehnt, nach mehr als 40.000 Partien in der langen Stufe.
Kleine Effekte kosten Partien
Kurze Stufe aller sieben Läufe: zwei klare Ergebnisse, fünf kleine. Kurze Stufe, 8 s + 0,08 s je Zug, mit 95-%-Halbbreite: T-0157 27,07, T-0158 2,75, T-0159 1,55, T-0160 -18,1, T-0161 3,07, T-0162 3,49, T-0163 -2,44.
Wie lange ein Test läuft, hängt von der Größe des Effekts ab. Die kurze Stufe dauerte bei T-0157 elf Minuten, bei T-0160 vierzehn. T-0159, die Tempoänderung, brauchte allein in der kurzen Stufe rund 72.000 Partien und fast neun Stunden. Über alle sieben Läufe hat das Orakel rund 180.000 Partien gespielt. Die genauen Werte:
| Lauf | Stufe | Ergebnis (Elo) | Partien |
|---|---|---|---|
T-0157 | lang, bestanden | +22,39 ± 8,18 | 1.694 |
T-0158 | lang, bestanden | +9,58 ± 5,23 | nicht angegeben |
T-0159 | kurz | +1,55 ± 1,13 | 71.692 |
T-0159 | lang, bestanden | +4,05 ± 2,89 | nicht angegeben |
T-0161 | lang, bestanden | +5,83 ± 3,87 | nicht angegeben |
T-0162 | lang, bestanden | +5,49 ± 3,69 | nicht angegeben |
T-0160 | kurz, abgelehnt | −18,10 ± 7,93 | 1.864 |
T-0163 | kurz, abgelehnt | −2,44 ± 3,53 | 9.816 |
Was fünf bestandene Läufe wert sind
Jeder dieser Gewinne ist gegen den eigenen Vorgänger gemessen, mit den Bedenkzeiten des Orakels. Zusammengezählt ergeben die fünf Gewinne der langen Stufe rund 47 Elo. Diese Summe überzeichnet den Fortschritt, aus zwei Gründen. Ein Test, der endet, sobald er seine obere Schranke erreicht, meldet im Mittel einen zu großen Gewinn; die Laufseiten sagen das neben jedem Wert. Und ein Gewinn im Spiel gegen sich selbst zählt gegen andere Engines weniger; AFE Anker-Fortschreibung der Elo: eine Schätzung der Spielstärke einer Coherent-Fassung auf der Skala der letzten Verankerung, fortgeschrieben mit den gemessenen Gewinnen der Läufe seither. Eine Schätzung, keine Messung. Ausführlich erklärt rechnet ihn mit dem Faktor 0,703 um.
Die Schätzung der Spielstärke auf der Website, AFE, berücksichtigt beides. Sie geht von der Verankerung der Fassung 0.2.0 bei rund 3600 gegen Engines anderer Projekte aus, einer Projektmessung außerhalb des Registers, und rechnet die sechs seither mit einem Gewinn in der langen Stufe bestandenen Läufe hinzu, die fünf oben und T-0154 vom 2026-10-03. Nach T-0162 steht sie bei rund 3630, mit einem nominellen Modellintervall von neunzig Prozent. Vom Gewinn im Spiel gegen sich selbst, der seit dieser Verankerung gemessen wurde, schreibt AFE nur einen Teil gut. Die Übertragung auf die Skala der Wertungsliste trägt einen weiteren Vorbehalt, der getrennt und nicht im Intervall angegeben wird. Die genauen Werte:
| Größe | Wert |
|---|---|
| Summe der fünf Gewinne der langen Stufe (Elo) | +47,34 |
Verankerung der Fassung 0.2.0 | 3600 ± 52 |
AFE nach T-0162 | 3628 |
| Nominelles Modellintervall von neunzig Prozent | 3605 bis 3651 |
| Gewinn im Spiel gegen sich selbst seit der Verankerung (Elo) | +51,36 |
| Von AFE gutgeschrieben (Elo) | rund +28 |
| Übertragung auf die Skala der Wertungsliste | ±51 |
AFE nach jedem bestandenen Lauf: Die Mitte steigt langsam, das Intervall wird breiter. AFE mit nominellem 90-%-Modellintervall: T-0157 3616, T-0158 3621, T-0159 3623, T-0161 3625, T-0162 3628.
Das Intervall wächst mit jedem Schritt, weil jeder Schritt seine eigene Unsicherheit mitbringt. AFE ist eine Schätzung, keine Messung: Die Laufseiten kennzeichnen den Wert als einen auf einem neuen Ankersatz, der nicht mit früheren verbunden ist, und ob die Intervalle so oft halten wie angegeben, ist noch nicht geprüft. Wie AFE gerechnet wird, erklärt der Beitrag „Von der fortgeschriebenen Zahl zu AFE“. Einen an einer Wertungsliste verankerten Wert liefert nur die Verankerung gegen Engines anderer Projekte.
Fünf bestandene Läufe in zweiundvierzig Stunden sind ein guter Abschnitt, kein Trend. Jeder Schritt ist klein, jeder wurde nur gegen die Fassung davor gemessen, und zwei von sieben Ideen haben nicht gehalten.