Der Lehrer von innen: Aufbau des Netzes der Breite 1536
Diesen Beitrag anhören19 Min.
Von KI aus dem Text dieses Beitrags erstellt und von der synthetischen Stimme „Sulafat“ gelesen; keine wörtliche Fassung, Fehler sind möglich.
Wird geladen …
Von KI aus dem Text dieses Beitrags erstellt und von der synthetischen Stimme „Sulafat“ gelesen; keine wörtliche Fassung, Fehler sind möglich.Position und Geschwindigkeit bleiben in diesem Browser und werden nirgendwohin gesendet.
Die Aufnahme konnte nicht abgespielt werden. Audiodatei öffnen
Der Lehrer T1536w-K64-v1 ist ein Bewertungsnetz der Breite 1536. Was er im Spiel leistet, stand im Beitrag „Die Netze von Coherent: Hauptnetz, Lehrer und Kaskade“. Hier geht es um sein Inneres: aus welchen Teilen er besteht, wie die Drohmerkmale gebildet werden, wie aus einer Stellung ein Wert wird und wie die Engine das während der Suche rechnet. Jede Zahl stammt aus der Netzdatei, der Ganzzahl-Referenz, der Trainerdefinition, dem Quelltext der Engine mit Lehrernetz oder den Prüfberichten dazu, oder sie ist daraus gerechnet. Stand: 5. November 2026.
Kurz
- Aufbau: Je Sicht
1.536Neuronen in der ersten Schicht, gespeist aus Steinmerkmalen mit8Königseimern und aus86.808Drohzeilen. Danach2Schichten mit je64Neuronen und1Ausgang. - Größe:
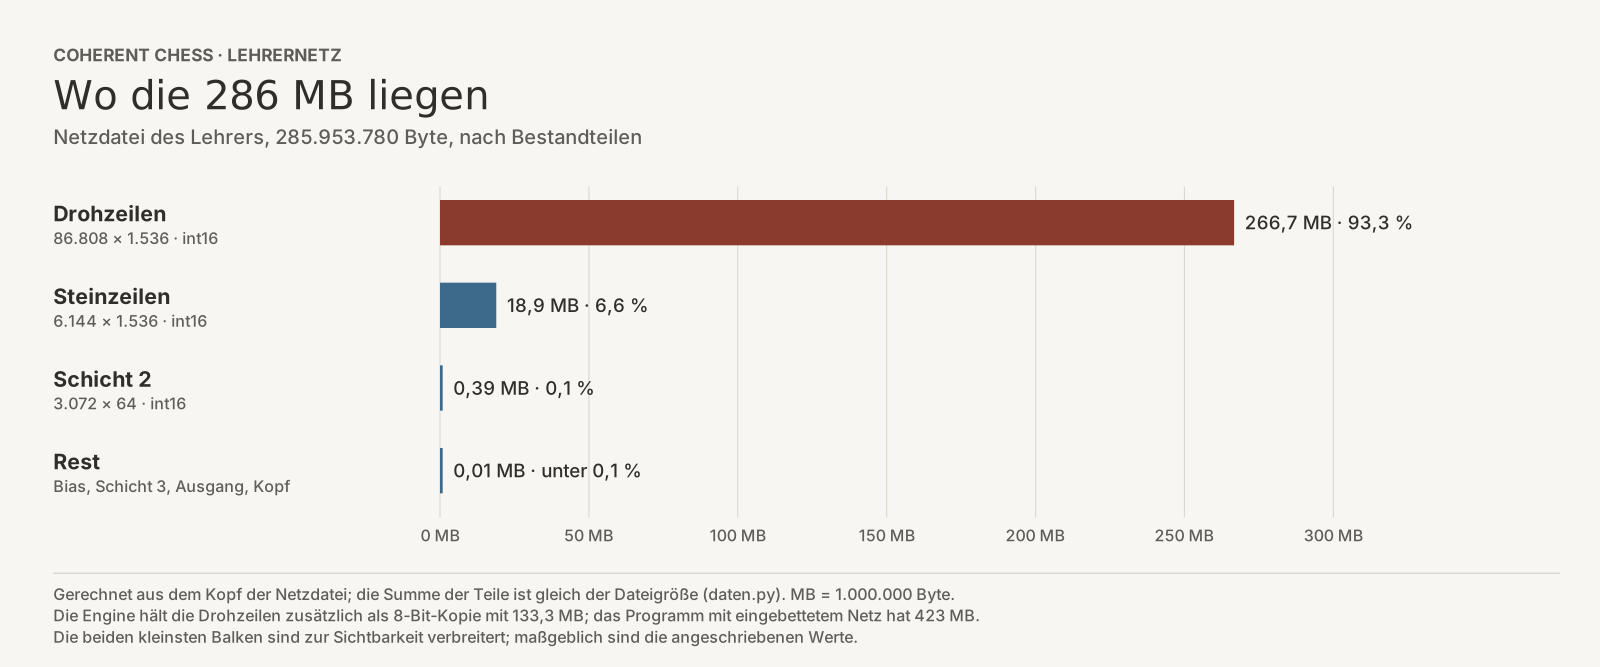
142.976.705Parameter, rund30-mal so viele wie im Hauptnetz.93,3% der Netzdatei sind Drohzeilen. - Drohmerkmale: Jedes Paar aus einem Stein und einem Stein, den er angreift, ist ein Merkmal, auch wenn der angegriffene Stein der eigene ist.
- Ablauf: Die Engine schreibt die Zwischensummen Zug für Zug fort und rechnet sie erst, wenn eine Bewertung gebraucht wird; bei Drohpaaren nur für die Steine, die der Zug betrifft.
- Prüfung: Die Engine rechnet auf
1.797.912Stellungen und Suchknoten bitgleich zu einer Ganzzahl-Referenz in Python, die die Netzdatei unabhängig vom Engine-Code liest.
Der Aufbau im Überblick
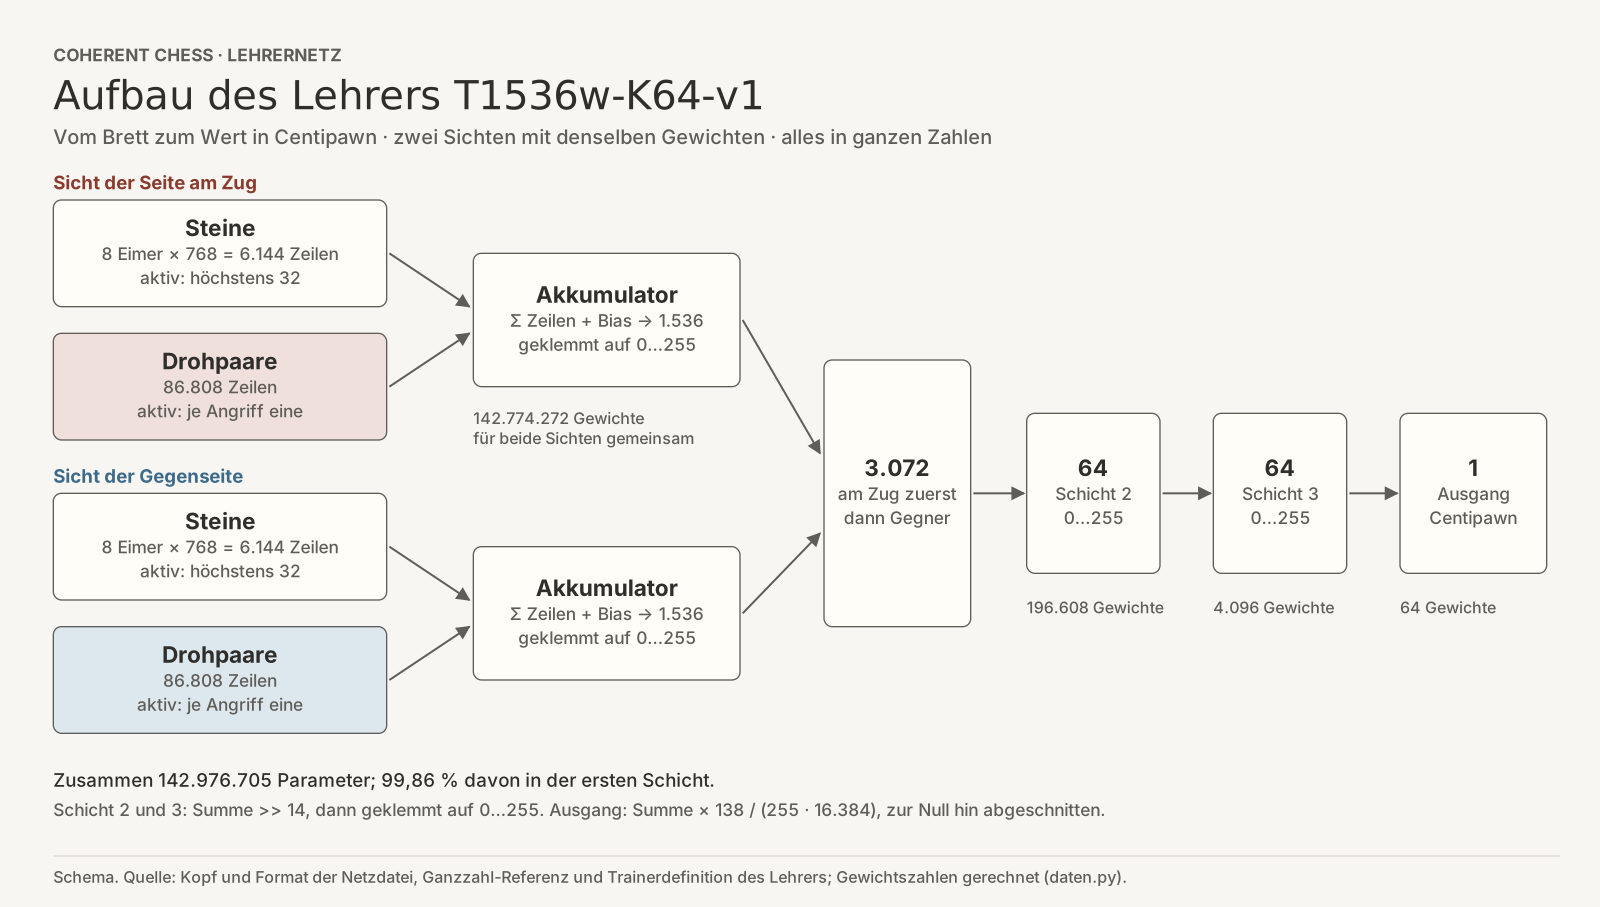
Das Netz betrachtet jede Stellung zweimal, einmal aus Sicht der Seite am Zug und einmal aus Sicht der Gegenseite. Beide Sichten benutzen dieselben Gewichte. Jede Sicht summiert die Zeilen ihrer aktiven Merkmale zu 1.536 Werten, dem Akkumulator. Beide Akkumulatoren, die Seite am Zug zuerst, ergeben 3.072 Eingänge für den Kopf. Der Kopf hat 2 Schichten mit je 64 Neuronen und einen Ausgang. Am Ende steht ein Wert in Centipawn aus Sicht der Seite am Zug.
Im Namen steht T für Lehrer, 1536 für die Breite, w für „funktionserhaltend aus dem Vorgänger verbreitert“, K64 für die Breite des Kopfes und v1 für die erste Version.
Was das Netz sieht
Steine. Je Sicht gibt es 768 Steinmerkmale: eigen oder fremd, mal 6 Figurenarten, Könige eingeschlossen, mal 64 Felder. Jeder Stein schaltet genau ein Merkmal ein, in einer regulären Stellung also höchstens 32. Schwarz sieht das Brett senkrecht gespiegelt und mit vertauschten Farben.
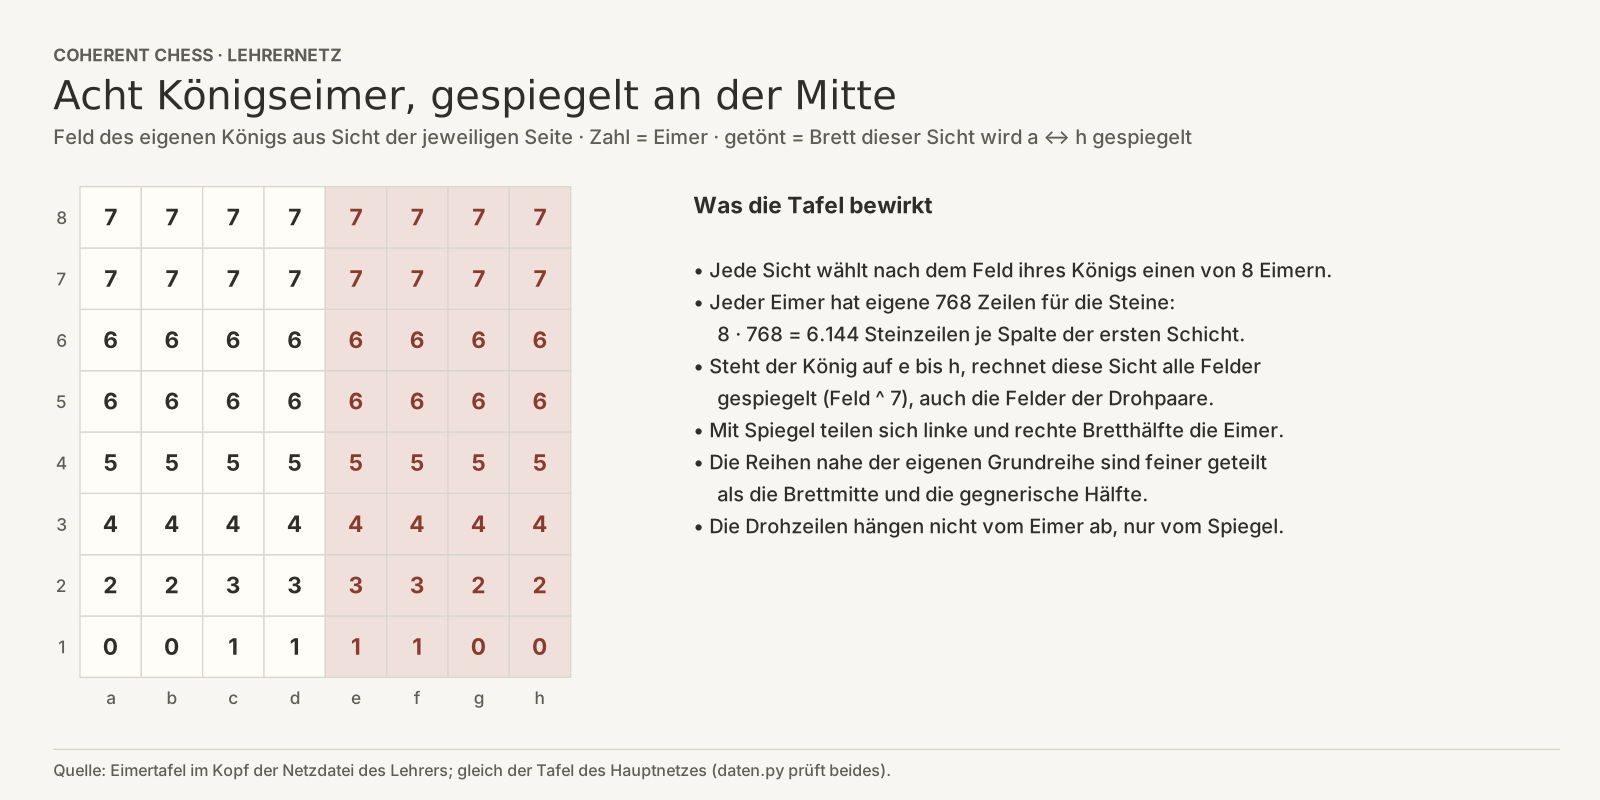
Königseimer. Das Feld des eigenen Königs wählt einen von 8 Eimern. Jeder Eimer hat eigene 768 Zeilen für die Steine, zusammen 8 · 768 = 6.144 Steinzeilen. Steht der eigene König auf den Linien e bis h, rechnet diese Sicht alle Felder gespiegelt (a ↔ h). Die Eimertafel ist dieselbe wie im Hauptnetz.
Was nicht eingeht. Rochaderechte, en passant, Halbzugzähler und Wiederholungen bekommt das Netz nicht. Wer am Zug ist, sieht es nur an der Reihenfolge der beiden Sichten.
Drohmerkmale: Paare aus Angreifer und Ziel
Ein Drohpaar besteht aus 4 Teilen: dem angreifenden Stein, seinem Feld, dem angegriffenen Feld und dem Stein, der dort steht. Ein Paar ist aktiv, wenn auf dem Zielfeld ein Stein steht und der Angreifer ihn erreicht. Gezählt wird die Angriffsgeometrie, unabhängig von Fesselungen und davon, wer am Zug ist. Für Läufer, Turm und Dame zählt je Richtung nur der erste Stein. Bauern zählen mit ihren Schlagfeldern, nicht mit dem Zug nach vorn. Der angegriffene Stein kann ein gegnerischer oder ein eigener sein. Ein Paar auf einen eigenen Stein ist eine Deckung.
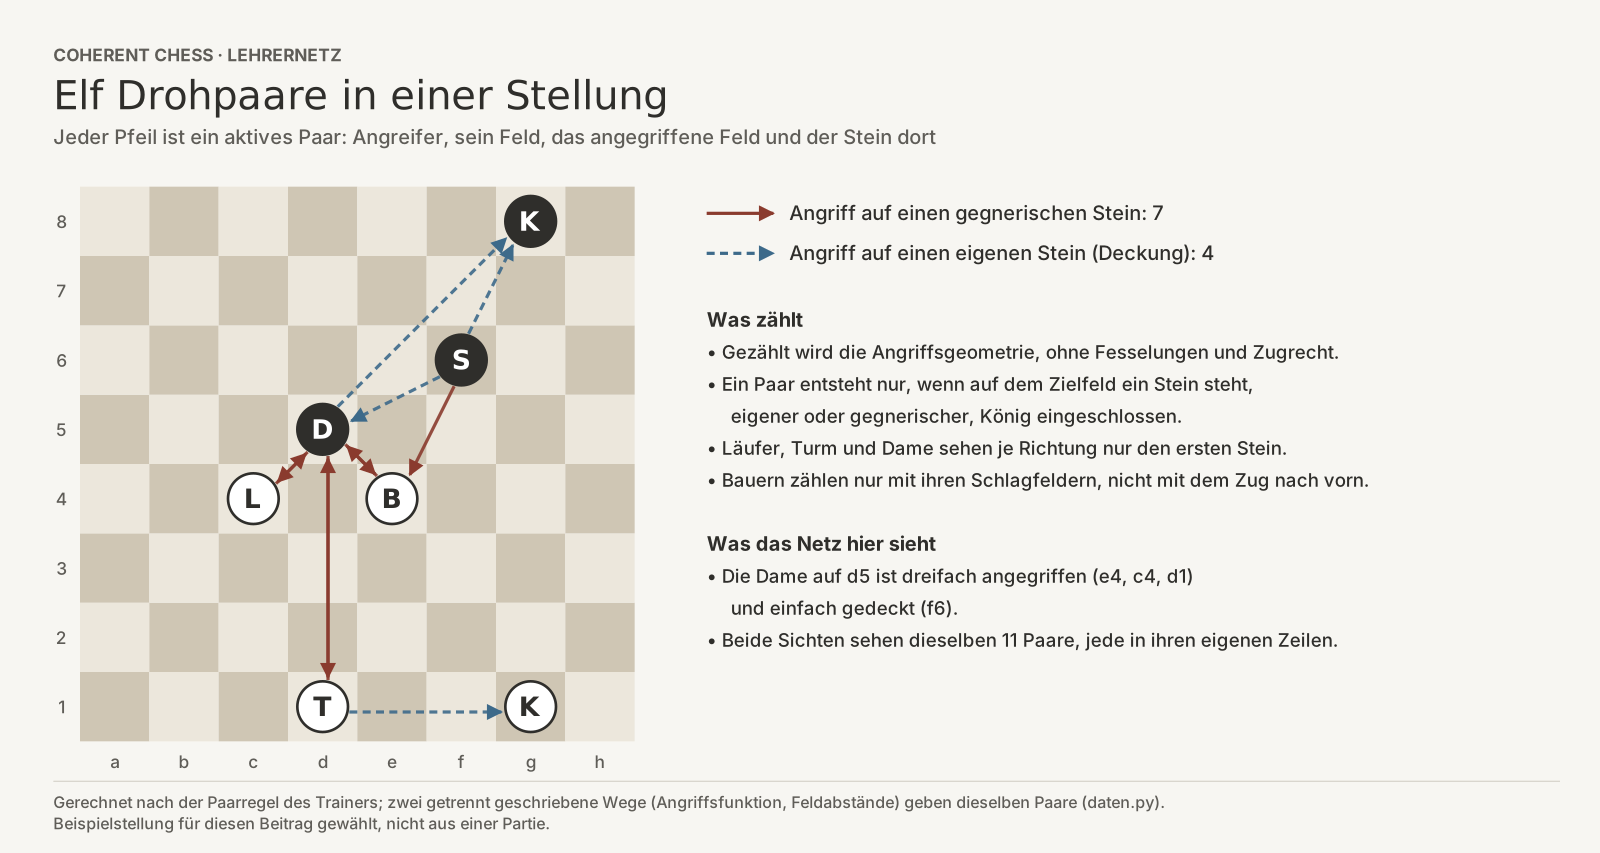
In der Beispielstellung sind 11 Paare aktiv, 7 auf gegnerische Steine und 4 auf eigene:
| Angreifer | Ziel | Art |
|---|---|---|
| Turm d1 | Dame d5 | Angriff |
| Läufer c4 | Dame d5 | Angriff |
| Bauer e4 | Dame d5 | Angriff |
| Dame d5 | Turm d1 | Angriff |
| Dame d5 | Läufer c4 | Angriff |
| Dame d5 | Bauer e4 | Angriff |
| Springer f6 | Bauer e4 | Angriff |
| Turm d1 | König g1 | Deckung |
| Dame d5 | König g8 | Deckung |
| Springer f6 | König g8 | Deckung |
| Springer f6 | Dame d5 | Deckung |
Die schwarze Dame ist dreifach angegriffen und einfach gedeckt. Diese Beziehungen gehen als einzelne Paare direkt in die Eingänge ein; ohne Drohmerkmale sieht ein Netz nur, welcher Stein auf welchem Feld steht. In der Grundstellung sind es je Sicht 40 Paare, alle Deckungen.
Wie viele Zeilen. Jede Kombination aus Angreifer (12 Steine), Feld, erreichbarem Zielfeld auf leerem Brett und Zielstein bekommt eine eigene Zeile. Auf leerem Brett gibt es 7.504 Kombinationen aus Angreifer, Feld und Zielfeld; Bauern stehen dabei nie auf Reihe 1 oder 8. Auf jedem Zielfeld sind 12 Zielsteine möglich, auf Reihe 1 und 8 nur 10, weil dort keine Bauern stehen. 1.620 der Kombinationen haben ihr Zielfeld auf Reihe 1 oder 8:
12 · 7.504 − 2 · 1.620 = 86.808 Drohzeilen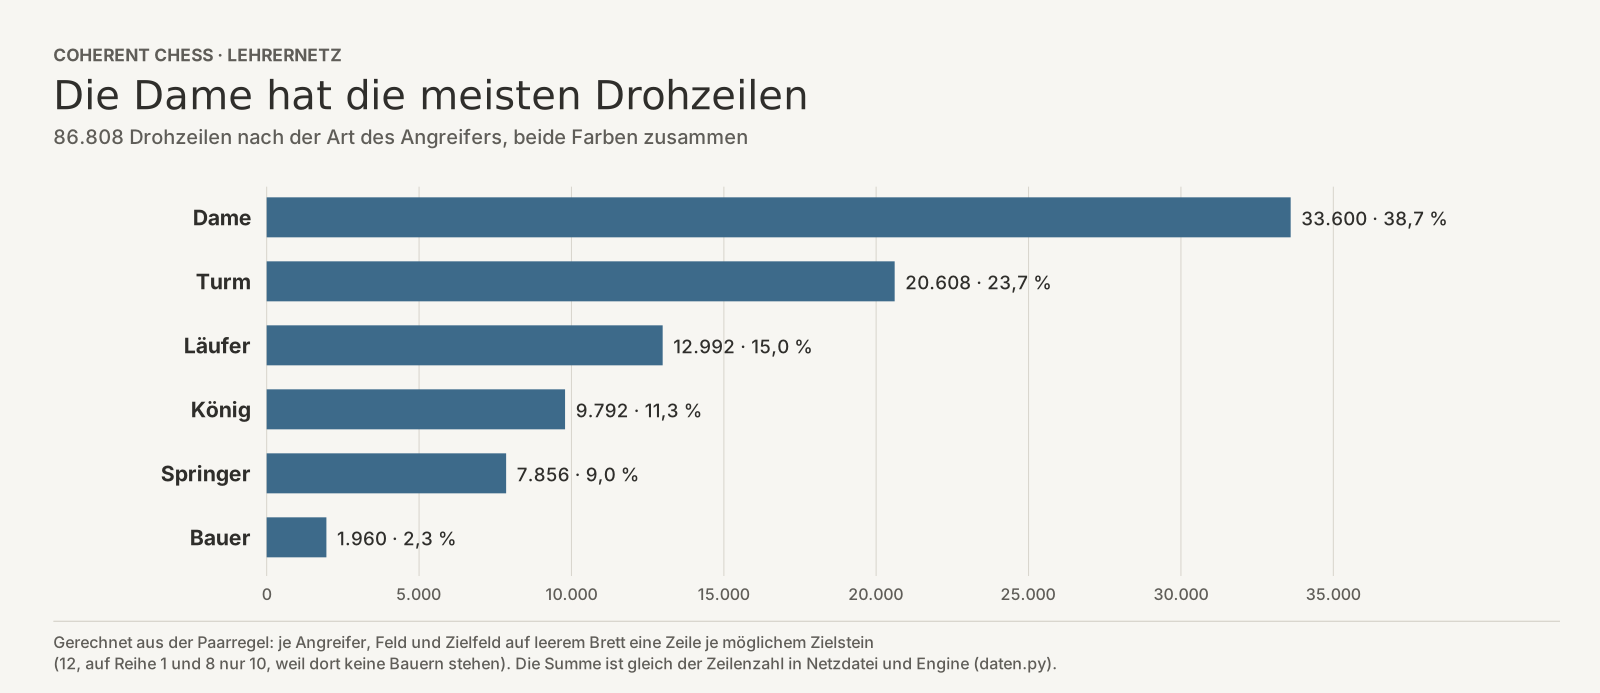
Fein und grob. Im Training hat jedes Paar zwei Zeilen: eine feine für genau dieses Paar und eine grobe für alle Paare mit derselben Farbe und Art von Angreifer und Zielstein auf demselben Zielfeld (2 · 6 · 2 · 6 · 64 = 9.216 grobe Zeilen). Beim Export werden beide addiert; die Engine kennt nur noch 86.808 zusammengelegte Zeilen. Die Drohzeilen hängen nicht vom Königseimer ab, wohl aber vom Spiegel: Die Felder eines Paars werden genauso gespiegelt wie die Felder der Steine. 12.166 der 86.808 Zeilen (14,0 %) sind nach dem Export ganz null.
Herkunft. Die Drohpaare gab es im Projekt schon vor dem Lehrer, in einem Forschungsnetz der Breite 768. Der Lehrer übernahm Paarregel und Anbindung in der Engine und verallgemeinerte sie auf andere Breiten und Köpfe. Eine viel kleinere Form von Drohmerkmalen beschrieb der Beitrag „Drohmerkmale: Zwischenstand zur kleinen Form D16“.
Die Rechnung in Formeln
Alle Werte sind ganze Zahlen. Für eine Sicht mit Königseimer e, aktiven Steinmerkmalen m und aktiven Drohpaaren p gilt für jedes der 1.536 Neuronen j:
a[j]  = clamp( b[j] + Σ_m W[e·768 + m][j] + Σ_p D[p][j], 0, 255 )
x     = ( a der Seite am Zug, a der Gegenseite )                 3.072 Werte
h2[k] = clamp( (c2[k] + Σ_i x[i] · V2[k][i]) >> 14, 0, 255 )      k = 1 … 64
h3[k] = clamp( (c3[k] + Σ_i h2[i] · V3[k][i]) >> 14, 0, 255 )     k = 1 … 64
Wert = trunc( (c4 + Σ_i h3[i] · V4[i]) · 138 / (255 · 16.384) ) Centipawn- Skalen:
255steht für1,0. Die Gewichte der ersten Schicht tragen den Faktor255, die übrigen Gewichte den Faktor2^14 = 16.384. Die Bias-Werte von Schicht2und3sind32-Bit-Zahlen, alle Gewichte16-Bit-Zahlen. - Ausgabeskala
138: Sie legt die Werte des Lehrers auf die Centipawn-Skala des Hauptnetzes. Mit demselben Anpassungsverfahren wie beim Hauptnetz ergaben sich auf1Million Validierungsstellungen165für das Hauptnetz und149für den Lehrer. Das Hauptnetz exportiert mit153;149 · 153 / 165 ≈ 138. - Aktivierung: CReLU, also auf
0bis255geklemmt, in allen drei verdeckten Stufen.
| Teil | Ein → aus | Gewichte | Bias |
|---|---|---|---|
| Steinzeilen | 6.144 → 1.536 | 9.437.184 | 1.536 |
| Drohzeilen | 86.808 → 1.536 | 133.337.088 | – |
Schicht 2 | 3.072 → 64 | 196.608 | 64 |
Schicht 3 | 64 → 64 | 4.096 | 64 |
| Ausgang | 64 → 1 | 64 | 1 |
Zusammen sind das 142.976.705 Parameter, 99,86 % davon in der ersten Schicht. Das Hauptnetz hat mit Breite 768, ohne Drohzeilen und mit einem Kopf aus 16 und 32 Neuronen 4.744.529 Parameter.
Der Ablauf in der Engine
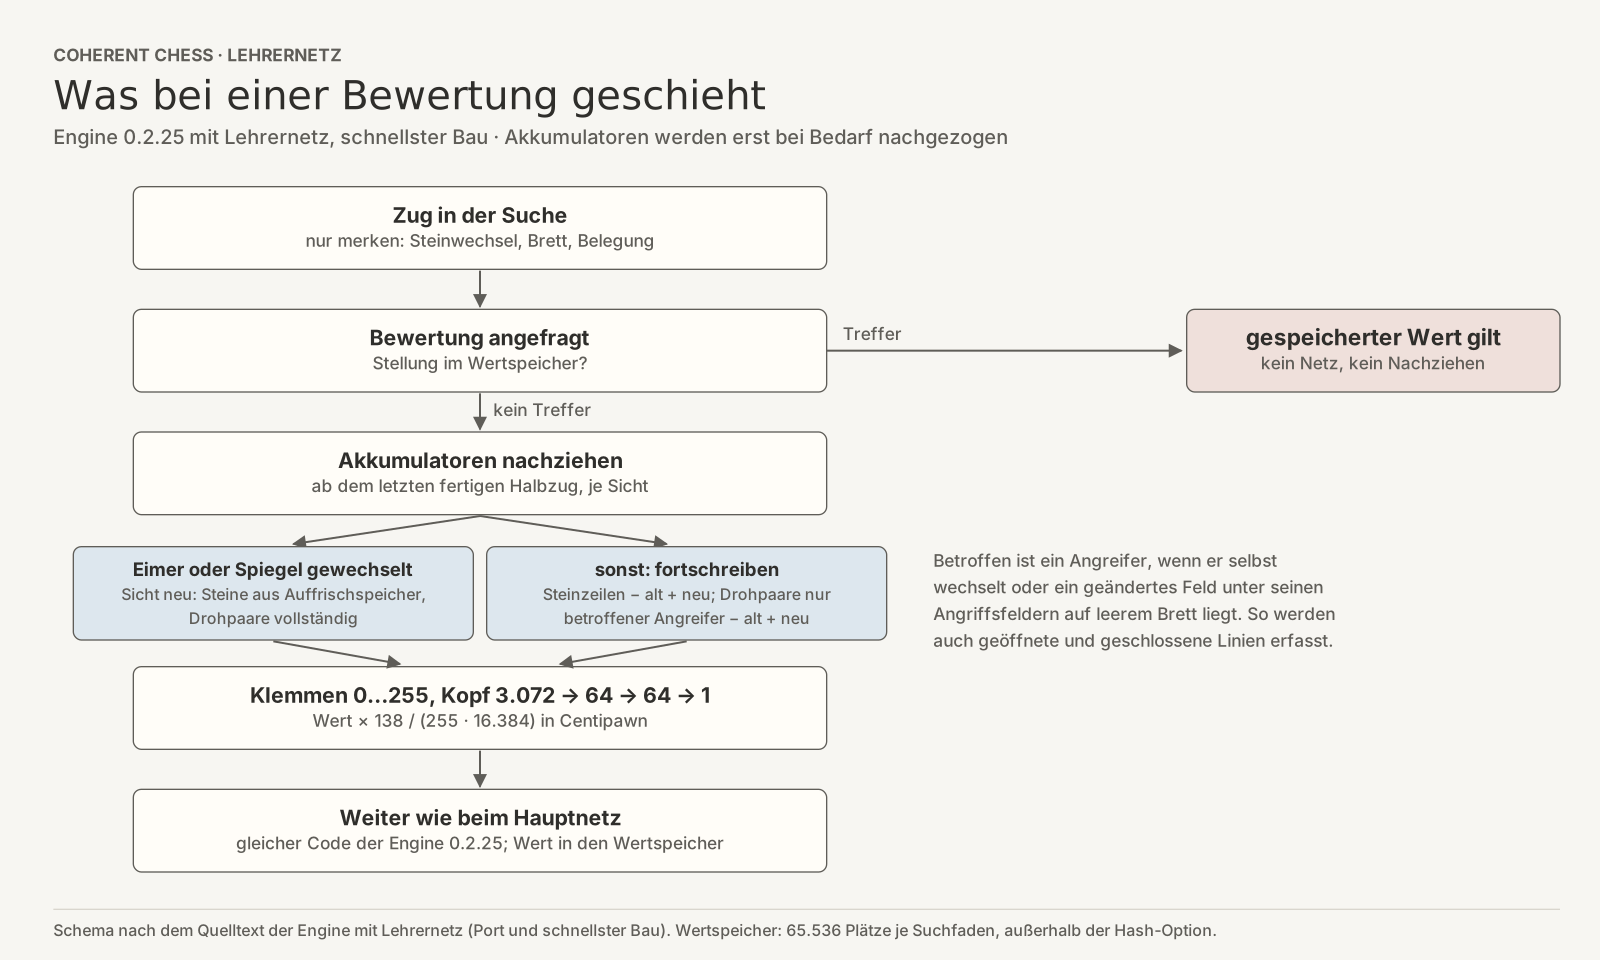
Von Grund auf summiert eine Sicht bis zu 32 Steinzeilen und alle aktiven Drohzeilen, jede 1.536 Zahlen breit. Das tut die Engine nur in bestimmten Fällen; sonst schreibt sie fort.
- Erst bei Bedarf. Bei jedem Zug merkt sich die Suche nur, welche Steine gehen und kommen, dazu Brett und Belegung. Gerechnet wird erst, wenn eine Bewertung gebraucht wird. Dann zieht die Engine jede Sicht vom letzten fertigen Halbzug aus nach.
- Nur die Änderung. Bei den Steinen werden die Zeilen der gehenden Steine abgezogen und die der kommenden addiert. Bei den Drohpaaren betrifft ein Zug jeden Stein, der selbst wechselt, und jeden Stein, in dessen Angriffsfeldern auf leerem Brett ein geändertes Feld liegt. Für diese Steine werden die alten Paare abgezogen und die neuen addiert. So werden auch Linien erfasst, die ein Zug öffnet oder schließt.
- Neuaufbau beim Eimerwechsel. Wechselt der König einer Sicht den Eimer oder die Brettseite, wird diese Sicht neu aufgebaut: die Steine über einen Auffrischspeicher, der die zuletzt gebaute Summe je Eimer und Spiegel samt Belegung hält, die Drohpaare vollständig.
Der schnellste Bau hat zwei weitere Hilfen. Ein Wertspeicher mit 65.536 Plätzen je Suchfaden merkt sich fertige Bewertungen; trifft eine Stellung, gilt der gespeicherte Wert, und Netz und Nachziehen entfallen. Die Drohzeilen in 8 Bit: Fast alle Zeilen passen ganz in −127 bis 127 und werden aus einer 8-Bit-Kopie gelesen, die halb so viel Speicher bewegt. Die übrigen tragen eine Marke und werden aus der 16-Bit-Tafel gelesen. In den Prüfungen änderte keine der beiden Hilfen einen Wert oder den Suchbaum.
Nach dem Netz geht der Wert denselben Weg wie beim Hauptnetz: Die Anpassung für das Lehrernetz ändert nur die Netzrechnung, den Wertspeicher und das kleinste zulässige Budget der Hash-Tabelle, nicht die Verarbeitung danach.
16 Bit reichen. Der Akkumulator liegt in 16-Bit-Zahlen. Damit die Summe mit den Drohzeilen dort sicher Platz hat, berechnet der Export für jedes Neuron konservative Grenzen der Zeilensumme ohne Bias, für Stellungen mit höchstens 32 Steinen, und legt einen festen Nullpunkt in ihre Mitte. Die Engine speichert die Summe minus Nullpunkt; nach diesen Grenzen bleibt der Betrag höchstens 9.524, die Grenze der 16-Bit-Zahl liegt bei 32.767. Nullpunkt und Eingangsbias kommen erst nach der Erweiterung auf 32 Bit hinzu. In der Prüfung mit 796.868 Suchknoten lag das gemessene Maximum bei 3.781.
Was es kostet. Die Netzdatei hat 285.953.780 Byte. Das Programm mit eingebettetem Netz und 8-Bit-Kopie hat 423 MB. In der ersten Tempomessung rechnete die Engine mit Lehrer 1,24 Millionen Knoten je Sekunde, dieselbe Engine mit Hauptnetz 3,46 Millionen; gemessen wurde an einem Bau, der sich nur in der Ausgabeskala unterschied. Zwei spätere Bauten wurden um 17,3 % und um weitere 11,7 % schneller, bei bitgleicher Bewertung.
Wie er trainiert wurde
- Warmstart: Der Lehrer begann als das Hauptnetz, funktionserhaltend verbreitert. Die alten
768Spalten und der alte Kopf wurden übernommen. Neue Spalten der ersten Schicht und neue Neuronen im Kopf begannen mit kleinen Zufallswerten. Ihre Verbindungen zu den alten Neuronen der nächsten Schicht und zum Ausgang begannen mit null, ebenso alle Drohzeilen. Vor dem ersten Schritt wich der rohe Netzausgang des Lehrers auf1Million Prüfstellungen höchstens um1,9 · 10^−6von dem des Hauptnetzes ab. - Daten:
16.584.642.797Zeilen aus dem gefilterten Datenbestand des Projekts, in einem Durchgang, mit Etiketten aus eigener Suche und dem Partieergebnis.200Datenpakete mit256.206.514Zeilen wurden nie trainiert und dienen als Prüfmenge. - Rezept: AdamW mit Lernrate
2 · 10^−5für alle Parameter,1.000Schritte Anlauf, danach Kosinus bis auf10% der Lernrate. Stapel4.096. Weight Decay0,01, für die Drohzeilen0. Das Abschlussprotokoll des Trainings weist insgesamt37,1GPU-Stunden aus, den ersten Abschnitt von6,1Stunden eingeschlossen. Der Beitrag „Die Netze von Coherent: Hauptnetz, Lehrer und Kaskade“ nannte43,2GPU-Stunden; dort war dieser erste Abschnitt doppelt gezählt.
Lernziel und Fehler je Stellung:
Ziel   = 0,5 · Ergebnis + 0,5 · sigmoid(Bewertung / 205)
Fehler = ( sigmoid(Netzausgang) − Ziel )²
Ergebnis ist der Partieausgang aus Sicht der Seite am Zug (1, 0,5 oder 0), Bewertung das Etikett der Suche in Centipawn.
| Netz | mittlerer Fehler auf der Prüfmenge |
|---|---|
| Hauptnetz | 0,015426 |
K2: Breite 768 ohne Drohzeilen, gleiche Daten | 0,014967 |
| Lehrer | 0,013900 |
| Lehrer mit abgeschalteten Drohzeilen | 0,020629 |
Gemessen auf allen 256.206.514 Zeilen der Prüfmenge. Für die Unterschiede Hauptnetz gegen K2, K2 gegen Lehrer und Hauptnetz gegen Lehrer liegen die einseitigen 99-%-Schranken (Bootstrap über die Datenpakete) jeweils deutlich über null. Schaltet man im fertigen Lehrer die Drohzeilen ab, wird sein Fehler größer als der des Hauptnetzes. Seine übrigen Gewichte wurden zusammen mit den Drohzeilen trainiert. Wie viel die Drohzeilen allein bringen, misst dieser Vergleich nicht.
Die Rundung auf ganze Zahlen änderte den mittleren Fehler in der Prüfung der Engine um 1,23 · 10^−5, von 0,013892 auf 0,013904.
Wie die Engine geprüft wurde
- Gleiche Werte wie die Referenz: Eine Ganzzahl-Referenz in Python liest die Netzdatei unabhängig vom Engine-Code und rechnet die Formeln oben. Die Engine stimmte bitgenau mit ihr überein: auf
1.000.000Prüfstellungen,1.044gezielt gewählten Stellungen und796.868Knoten aus Suchen, darunter37.039Knoten mit Schach,39.447mit Schlagzug,2.741mit Umwandlung,2.517mit Rochade und533mit en passant. Der einfache Rechenweg und die Vektorwege fürAVX2undAVX-512liefern dasselbe, ebenso Fortschreiben und Neuaufbau. - Hauptnetz unverändert: Mit dem Hauptnetz rechnet die angepasste Engine bitgleich zur Engine
0.2.25: gleiche bench-Zahl603und256gleiche Suchen bei100.000Knoten. - Schnellere Bauten: gleiche Bewertungen, gleicher Suchbaum bei festen Knoten (
256Suchen bei100.000und64bei1.000.000Knoten), bench727wie der erste Lehrerbau. Ein Prüfbau zählte in2Läufen1.721.724Treffer des Wertspeichers ohne Abweichung. - Codeprüfung: Für die Anpassung der Engine und für den schnellsten Bau liegt je eine Codeprüfung mit Freigabe vor.
Was dieser Beitrag nicht sagt
- Keine Spielstärke. Werte im Spiel stehen im Beitrag „Die Netze von Coherent: Hauptnetz, Lehrer und Kaskade“; dort sind sie als interne Messungen des Projekts gekennzeichnet, nicht als Orakelurteile.
- Keine Zerlegung. Wie viel Breite, Drohzeilen und größerer Kopf jeweils beitragen, ist nicht gemessen. Der Vergleich mit abgeschalteten Drohzeilen zeigt nur, wie stark das fertige Netz von ihnen abhängt.
- Die Grundlagen des Netzaufbaus, an einem älteren Hauptnetz, beschreibt der Beitrag „Das Netz von Coherent 0.2.13“.
Wie das geprüft wurde
- Quellen: Kopf und Größe der Netzdatei, der Exportbeleg mit Nullpunkten und Schranken, die Ganzzahl-Referenz, die Trainerdefinition und das Trainingsprogramm, die Paketbeschreibungen des Lehrers, die Anpassung der Engine und die beiden schnelleren Bauten im Quelltext, die Auswertung auf der Prüfmenge und die Prüfberichte der Engine.
- Nachrechnung: Ein Skript liest den Kopf der Netzdatei, rechnet daraus Teile, Parameter und Bytes und vergleicht die Summe mit der Dateigröße. Es zählt die Drohzeilen aus der Paarregel nach und vergleicht sie mit Referenz, Engine und Trainer. Die Paare bildet es auf zwei getrennt geschriebenen Wegen, einmal mit der Angriffsfunktion des Trainers, einmal aus Feldabständen und Zwischenfeldern; beide stimmen auf der Beispielstellung, der Grundstellung und
3.000Zufallsbelegungen überein. - Unabhängige Prüfung: Text, Tabellen und Grafiken wurden unabhängig gegen dieselben Quellen geprüft und die Zahlen nachgerechnet. Die Prüfung fand die doppelt gezählte Rechenzeit.