Netz der Breite 1024: Plan, Rechnung und Stand vor dem Start
Diesen Beitrag anhören10 Min.
Von KI aus dem Text dieses Beitrags erstellt und von der synthetischen Stimme „Sulafat“ gelesen; keine wörtliche Fassung, Fehler sind möglich.
Wird geladen …
Von KI aus dem Text dieses Beitrags erstellt und von der synthetischen Stimme „Sulafat“ gelesen; keine wörtliche Fassung, Fehler sind möglich.Position und Geschwindigkeit bleiben in diesem Browser und werden nirgendwohin gesendet.
Die Aufnahme konnte nicht abgespielt werden. Audiodatei öffnen
Das Bewertungsnetz von Coherent hat in seiner ersten Schicht 768 Neuronen je Seite. Ein Plan prüft, ob ein Netz mit 1024 Neuronen, auf denselben Daten trainiert, stärker spielt, den Preis an Rechenzeit eingerechnet. Dieser Beitrag zeigt, was geplant ist, wie lange das Training nach Plan dauert, was schon gemessen wurde und was noch fehlt. Stand ist der 28.10.2026, etwa 11:45 UTC. Das Training hat zu diesem Zeitpunkt noch nicht begonnen. Es gibt noch kein trainiertes Netz und kein Ergebnis zur Spielstärke.
Die Frage
Spielt ein Netz der Breite 1024 stärker als das Netz der Breite 768, wenn beide mit demselben Rezept, denselben Daten und derselben Saat trainiert werden? Die Saat ist der Startwert des Zufallsgenerators; gleiche Saat heißt gleiche Reihenfolge der Trainingsdaten. Das Netz der Breite 768 ist die Kontrolle. Der Plan wurde vor jedem Lauf gesiegelt, also festgeschrieben, nachdem zwei Modellfamilien ihn geprüft hatten. Spätere Ergebnisse ändern ihn nicht.
Das Netz
Jede Stellung wird aus Sicht beider Seiten in 768 Merkmale übersetzt: 2 Farben × 6 Steinarten × 64 Felder.
Merkmal = (fremder Stein ? 1 : 0) · 384 + Steinart · 64 + Feld
Die Gewichte der ersten Schicht hängen zusätzlich davon ab, in welchem von 8 Bereichen der eigene König steht (Königseimer). Für jede Seite entsteht so ein Akkumulator a der Breite B, auf [0, 1] begrenzt (CReLU). Danach folgen 2 kleine Schichten mit 16 und 32 Neuronen und ein Ausgang:
y = w₃ · c(W₂ · c(W₁ · [a_am Zug ; a_Gegner] + b₁) + b₂) + b₃, mit c(x) = min(max(x, 0), 1)
Die Zahl der Parameter im fertigen Netz:
P(B) = 8 · 768 · B + B + (2B · 16 + 16) + (16 · 32 + 32) + 33
Breite B | Parameter | davon erste Schicht |
|---|---|---|
768 | 4.744.529 | 4.719.360 |
1024 | 6.325.841 | 6.292.480 |
Das breite Netz hat 1,333-mal so viele Parameter; fast alle stecken in der ersten Schicht.
Das breite Netz hat 1,333-mal so viele Parameter, fast alle in der ersten Schicht. erste Schicht: 768 4.719.360, 1024 6.292.480; übrige Schichten: 768 25.169, 1024 33.361.
Daten und Training
-
Daten: ein Verbund aus
4Datensätzen mit zusammen56.149.275.622Zeilen. Jede Zeile ist eine Stellung mit einer Bewertung und dem Ausgang ihrer Partie. Aufgeteilt wird80/10/10; trainiert wird auf44.862.491.563Zeilen,79,9% des Verbunds. -
Epochen:
16. Jede Epoche läuft einmal über den ganzen Trainingsteil, zusammen717.799.865.008Zeilen. -
Ziel und Verlust: Das Netz lernt eine Mischung aus Partieausgang
eund Bewertungsin Centipawns:z = 0,5 · e + 0,5 · σ(s / 205),Verlust = Mittelwert von (σ(y) − z)², mitσ(x) = 1 / (1 + e^(−x)) -
Optimierer: AdamW mit Lernrate
η₀ = 0,00025, Stapel zu4.096Zeilen. Die Lernrate fällt je Schrittkauf einer Kosinuskurve bis null:η(k) = η₀ · ½ · (1 + cos(π · k / (S − 1))), mitS = 16 · ⌈44.862.491.563 / 4.096⌉ = 175.244.112Schritten -
Gleich wie die Kontrolle: Rezept, Daten, Reihenfolge der Daten und Saat. Nur die Breite ändert sich.
Wie lange es dauert
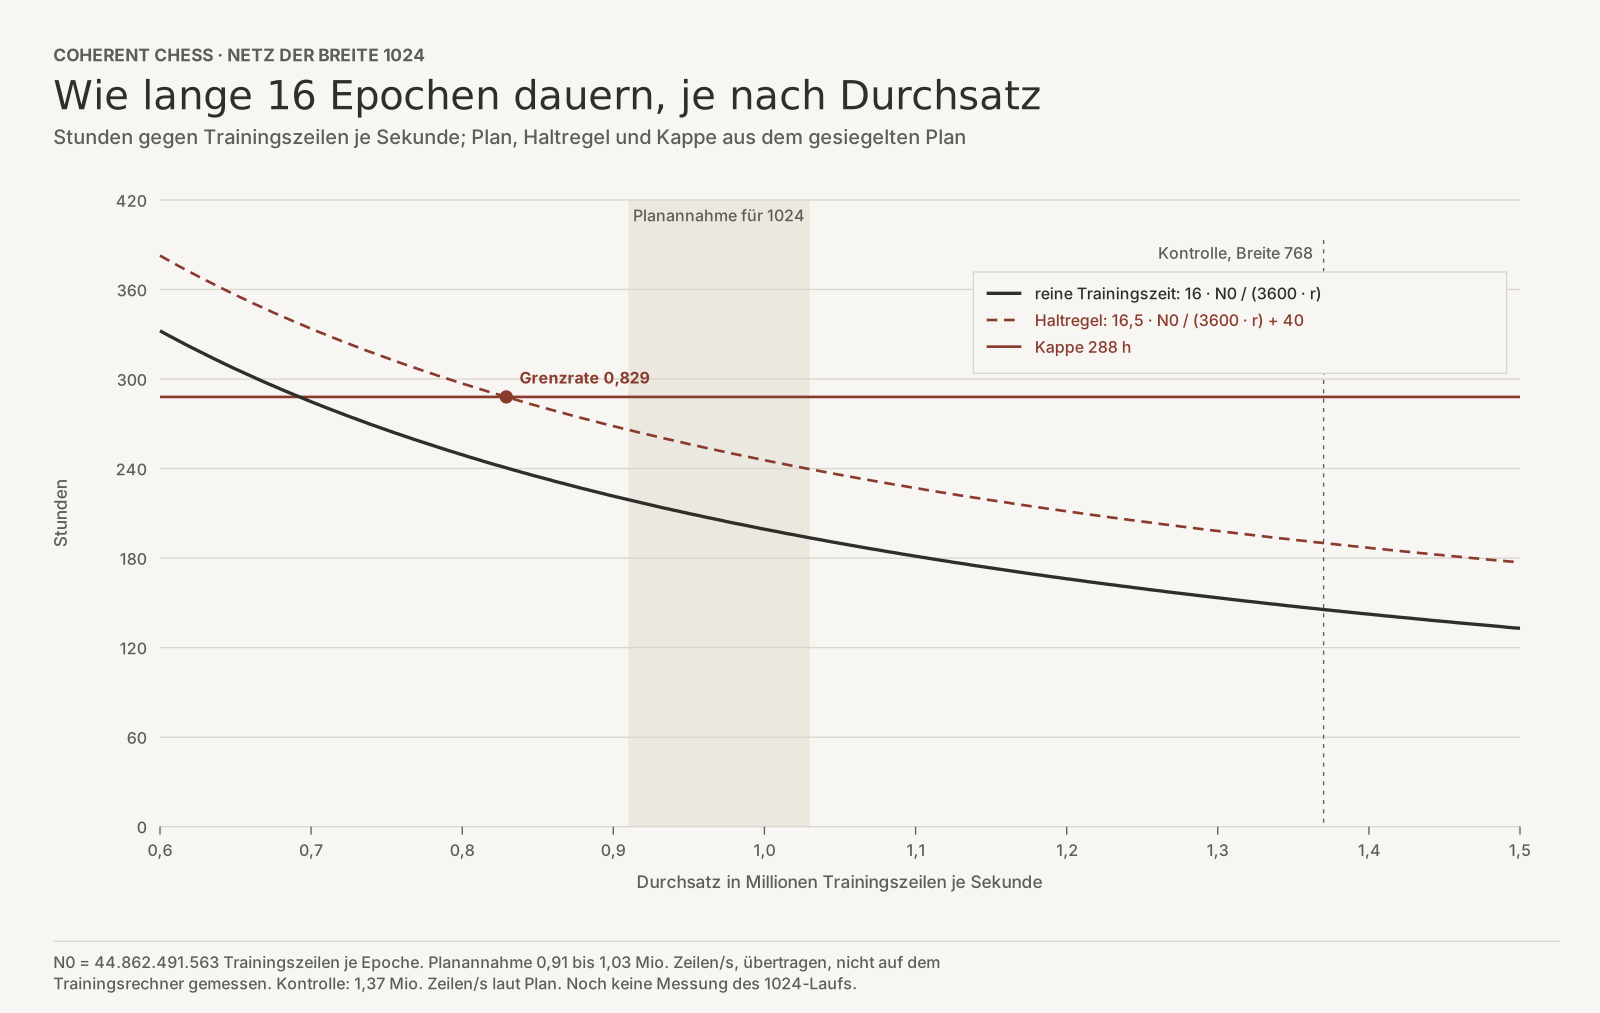
Die Dauer hängt am Durchsatz r, den Trainingszeilen je Sekunde:
Trainingszeit in Stunden = 16 · N0 / (3600 · r), mit N0 = 44.862.491.563
- Gemessen in früheren Läufen: Die Kontrolle mit Breite
768trainiert mit1,37Mio. Zeilen je Sekunde. Auf einem früheren, kleineren Datensatz brauchte ein Netz der Breite102494,7Stunden, eines der Breite76863,1Stunden, Faktor1,50. - Planannahme:
0,91bis1,03Mio. Zeilen je Sekunde für das breite Netz. Das entspricht1,37geteilt durch1,50und durch1,33, das Verhältnis der Parameter. Daraus folgen194bis219Stunden für16Epochen, mit Schlussauswertung200bis225Stunden, also gut8bis9Tage. Diese Werte sind übertragen, nicht auf dem Trainingsrechner gemessen. - Kappe: Der Lauf darf höchstens
288Stunden dauern. - Haltregeln:
1und6Stunden nach dem Start wird der Fortschritt festgehalten und der Durchsatzrdaraus berechnet. Ist16,5 · N0 / (3600 · r) + 40 > 288, wird der Lauf beendet. Unabhängig davon endet er, wenn Epoche1länger als54.109Sekunden dauert. Beide Regeln greifen unterhalb derselben Rate von etwa0,829Mio. Zeilen je Sekunde. Sie sind technisch: Kein Verlust- oder Spielwert entscheidet über einen Abbruch.
Was schon gemessen ist
-
Tempo-Vortor: Ein breiteres Netz kostet beim Bewerten mehr Rechenzeit. Für den Start nach unverändertem Plan musste das Verhältnis der Suchgeschwindigkeiten mindestens
0,875betragen:r̂ = Knoten je Sekunde mit Breite 1024 / Knoten je Sekunde mit Breite 768 ≥ 0,875Die Regel wurde am
28.10.2026um06:05UTC gesiegelt, bevor ein Wert gelesen wurde. Darunter wären eine neue Nutzen-Kosten-Prüfung durch zwei Modellfamilien und eine ausdrückliche Entscheidung nötig gewesen, bei einer ungültigen Messung eine Wiederholung. Um06:06UTC war das Tor bestanden. Den Messwert nennt dieser Beitrag nicht; nach Plan erhält auch die Freigabestelle nur das Urteil. -
Vorversuche: Zwei kleinere Versuchsreihen, mit
2,2Mrd. Zeilen und3Saaten und mit13,59Mrd. Zeilen und1Saat, erhielten im Vergleich mit Partien beide das Urteil „offen“. Der Plan stellt die Frage nun auf dem größten Datenverbund.
Wie danach entschieden wird
Nach dem Training spielen die beiden Netze Partien gegeneinander, das breite Netz gegen die Kontrolle. Die Regel, wann das breite Netz als stärker gilt, als nicht stärker oder als offen, steht vorab im Plan. Einen Verlustwert als Tor gibt es nicht: Der Trainingsverlust entscheidet nichts, nur Partien.
Stand am 28.10.2026
- Plan: gesiegelt am
27.10.2026, mit2Nachträgen. Nachtrag1legt den Trainingsrechner fest, Nachtrag2das Tempo-Vortor. - Tempo-Vortor: bestanden.
- Daten: Der Verbund wird auf den Trainingsrechner kopiert. Laut Kopierprotokoll lagen um
11:44UTC2.471.903.383.090von4.548.091.328.767Byte dort, rund54%. Gestartet wird nur mit vollständiger Kopie, deren Prüfsummen mit der abgenommenen Quelle übereinstimmen. - Start: Er setzt unter anderem auch gleiche Software wie bei der Kontrolle, bestandene Startproben und eine ausdrückliche Freigabe voraus. Fehlt eine Bedingung, startet nichts.
- Trainingsrechner: Seine Grafikkarte rechnet seit
11:11UTC einen anderen Lauf. - Kontrolle: Das Netz der Breite
768wird noch trainiert; um11:31UTC stand es in Epoche10von16.
Was es noch nicht gibt
- Kein Training des Netzes der Breite
1024hat begonnen; es gibt keinen gemessenen Durchsatz und keinen Verlustwert. - Es gibt kein Ergebnis zur Spielstärke. Ob das breite Netz stärker spielt, ist offen.
Wie das geprüft wurde
- Quellen: der gesiegelte Plan mit beiden Nachträgen, das Rezept des Trainings, der Code des Trainers und das Startskript des Laufs, der Eintrag zum Tempo-Vortor im Arbeitsstand, das Kopierprotokoll und das Projektjournal.
- Unabhängige Prüfung: Ein Agent einer anderen Modellfamilie prüfte Text, Bild und Diagramm in
2Runden gegen dieselben Quellen und rechnete die Kennzahlen selbst nach. Er bestätigte die Rechnungen und benannte ungenaue Formulierungen, darunter das Urteil der Vorversuche und die Belege zum Stand; sie sind eingearbeitet. - Nachrechnung: Ein Skript prüft ausgewählte Quelleneinträge und rechnet zentrale Kennzahlen nach, darunter Parameterzahlen, Schrittzahl, Trainingsanteil, Dauern und die Grenzraten beider Haltregeln.