Eine Tafel je Vorwärtslauf: schnelleres Netztraining
Diesen Beitrag anhören7 Min.
Von KI aus dem Text dieses Beitrags erstellt und von der synthetischen Stimme „Sulafat“ gelesen; keine wörtliche Fassung, Fehler sind möglich.
Wird geladen …
Von KI aus dem Text dieses Beitrags erstellt und von der synthetischen Stimme „Sulafat“ gelesen; keine wörtliche Fassung, Fehler sind möglich.Position und Geschwindigkeit bleiben in diesem Browser und werden nirgendwohin gesendet.
Die Aufnahme konnte nicht abgespielt werden. Audiodatei öffnen
Am 2026-10-18 um 23:42 UTC wurde eine Rechenabkürzung in den Trainer der Bewertungsnetze übernommen, für neue Trainingsläufe. Sie betrifft nur das Training, nicht die Engine, und erhält das Lernziel; Rundung kann aber zu anderen Trainingsverläufen führen. Messbar ändert sie die Zeit je Trainingsschritt. Dieser Beitrag beschreibt, was sich ändert, wie es geprüft wurde und was das Ergebnis bedeutet. Er entstand im Auftrag des Betreibers. Er macht keine Aussage über Spielstärke.
Was sich ändert
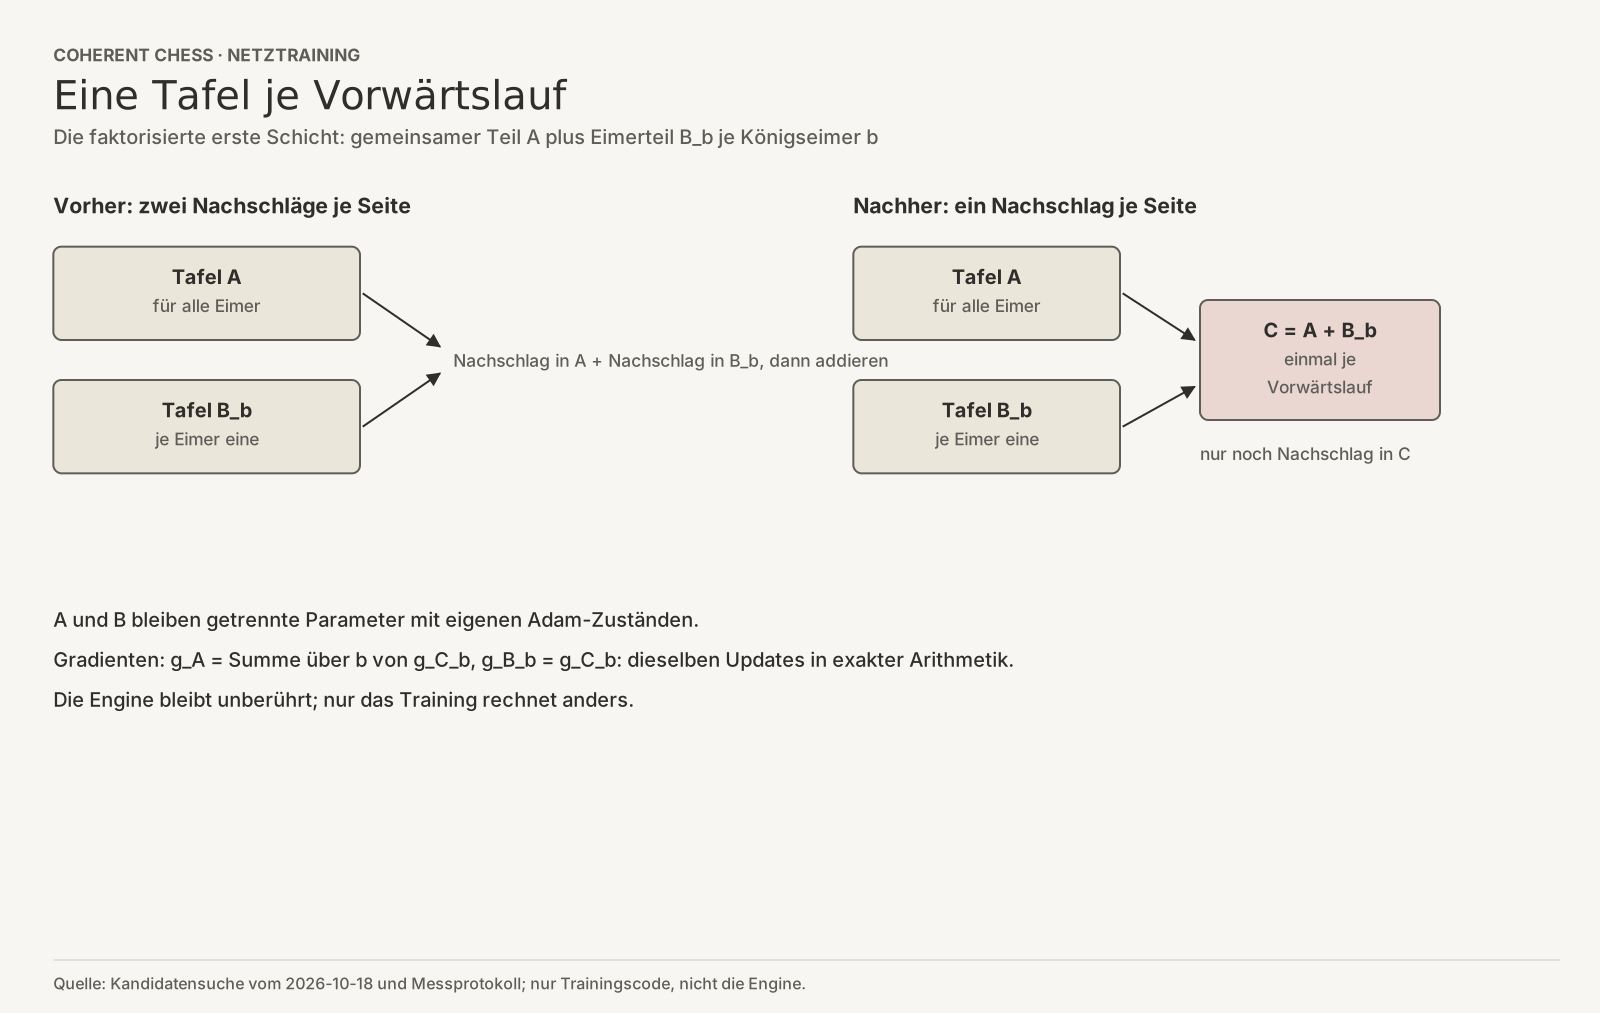
Die erste Schicht des Netzes ist im Training faktorisiert. Für jeden Königseimer b setzen sich ihre Gewichte aus einem gemeinsamen Teil A und einem Eimerteil B_b zusammen. Bisher schlug das Training für jede Seite die aktiven Merkmale in beiden Tafeln nach und addierte die Ergebnisse. Die Abkürzung bildet stattdessen einmal je Vorwärtslauf die Summe C = A + B_b für alle Eimer und schlägt nur noch in C nach.
Rechnerisch ist das dasselbe Training. Der Gradient nach C verteilt sich wie zuvor: A erhält die Summe der Gradienten aller Eimer, B_b den Gradienten seines Eimers. A und B bleiben getrennte Parameter mit eigenen Adam-Zuständen. Das ist nötig: Ein gemeinsamer Zustand würde die Summe bei gleichgerichteten Gradienten im ersten Schritt nur etwa halb so weit bewegen.
Herkunft und Kriterium
Der Vorschlag entstand am 2026-10-18 in einer Kandidatensuche nach Hebeln für das Netztraining, die der Betreiber angestoßen hatte. Drei Prüfer hielten den Vorschlag nach Nachforderungen für tragfähig; die Gleichheit der Gradienten ist für exakte Arithmetik bewiesen. Die im Vorschlag geschätzte Zeitersparnis von 10 bis 20 Prozent galt als nicht hergeleitet. Ein Schwestervorschlag wurde mit einem nachgerechneten Gegenbeispiel widerlegt. In der Rangliste nach erwartetem Nutzen je Rechenstunde stand dieser Vorschlag vorn, mit der Erwartung 0 Elo Stärkeabstand zum Gegner, aus den Partien geschätzt, mit 95-Prozent-Halbbreite, wo das Orakel eine berichtet hat. Nie eine absolute Wertung. bei billigerem Training.
Vor der Messung standen die Kriterien fest, in einem Protokoll, das vor dem Lauf zweimal unabhängig geprüft wurde:
- Gleichheit: höchste Abweichung der Gradienten über alle Parameter höchstens
1e-6, mit Testgewichten, bei denen die Klemmung der Gewichte tatsächlich greift. - Tempo: Die untere 95-Prozent-Grenze des Verhältnisses der Schrittzeiten liegt über 1,05.
Die Messung
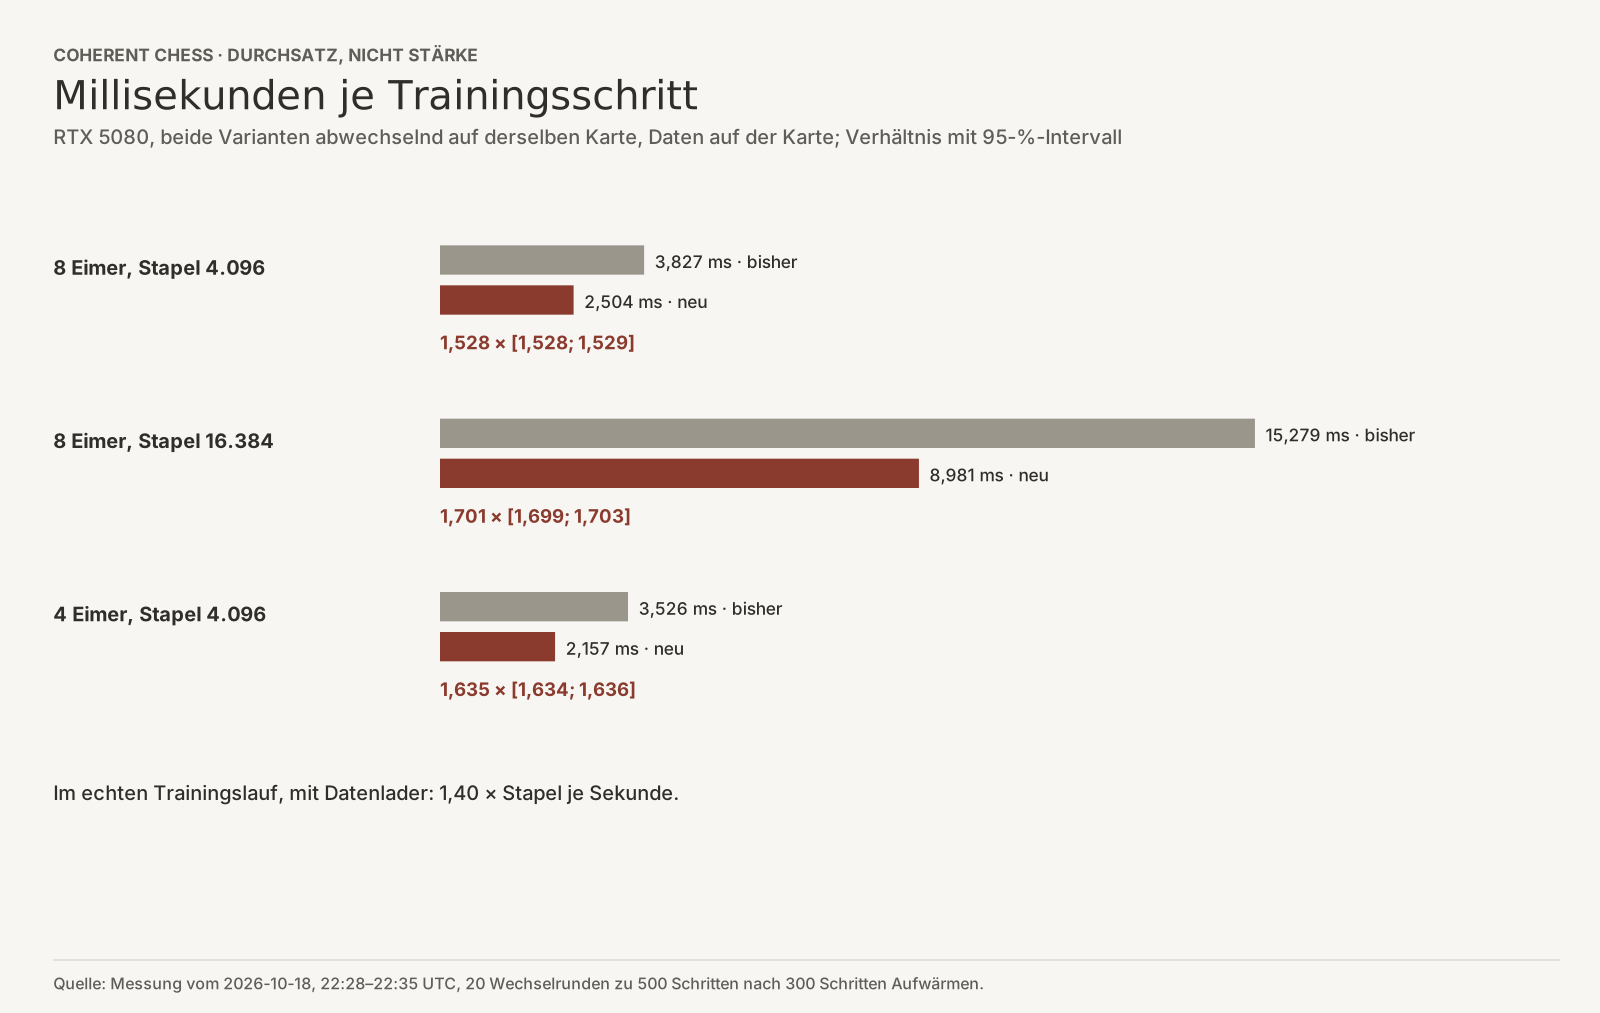
Gemessen wurde am 2026-10-18 von 22:28 bis 22:35 UTC auf einer Grafikkarte RTX 5080, deterministisch, beide Varianten abwechselnd auf derselben Karte: je 20 Wechselrunden zu 500 Schritten nach 300 Schritten Aufwärmen.
- Gleichheit: Die größte Gradientenabweichung lag in float64 bei höchstens 8,7·10⁻¹⁹, in float32 bei rund 1,8·10⁻⁸. Nach 20 Optimierungsschritten mit Klemmung in float64 wichen Parameter und Adam-Momente um rund 4,6·10⁻¹⁶ ab.
- Hauptkonfiguration, 8 Eimer, Stapel 4.096: von 3,827 auf 2,504 ms je Schritt, Faktor 1,528 [1,528; 1,529].
- Stapel 16.384: Faktor 1,701. Mit 4 Eimern: Faktor 1,635.
- In der ersten gemessenen Runde der Hauptkonfiguration lag die Spitze des für Tensoren belegten Grafikspeichers bei 443 MB mit der Abkürzung und 447 MB bisher; beide Varianten waren dabei im Speicher.
Gemessen war der reine Trainingsschritt mit Daten auf der Karte, ohne Datenlader. In einem echten Trainingslauf mit Lader waren es 1,40-mal so viele Stapel je Sekunde. Neben der Messung hielt ein anderer Prozess einen ruhenden Grafikkontext ohne Last; das Protokoll ließ das per Nachtrag vor dem Lauf zu.
Vom Vorschlag zur Übernahme: der Weg der Abkürzung: 1. Vorschlag entsteht in einer Kandidatensuche; 2. Drei Prüfer: Vorschlag nach Nachforderungen tragfähig; 3. Kriterien im Protokoll festgelegt, zweimal unabhängig geprüft; 4. Messung: beide Varianten abwechselnd, 20 Runden zu 500 Schritten; 5. In den Trainer übernommen, für neue Trainingsläufe.
Was das heißt und was nicht
Netze werden schneller fertig, also passen mehr Trainingsversuche in dieselbe Zeit. Das ist ein reiner Durchsatzbefund. Ob daraus Spielstärke wird, entscheidet nur das Orakel. Die Faktoren gelten für diese Karte und diese Konfigurationen; auf andere Karten übertragen sind sie nicht. In float32 laufen alter und neuer Rechenweg nach einigen hundert Schritten durch Rundung auseinander. Neue Netze sind deshalb nicht bitgleich zu alten mit derselben Saat, auch wenn die Rechnung mathematisch dieselbe ist.
Wie das geprüft wurde
Die Fakten stammen aus dem Ergebnis der Kandidatensuche, dem Messprotokoll mit Nachtrag und dem Messergebnis samt Übernahmevermerk. Ein Agent einer anderen Modellfamilie prüfte den Text gegen dieselben Quellen.