Prüfstellungen in den Trainingsdaten
Diesen Beitrag anhören5 Min.
Von KI aus dem Text dieses Beitrags erstellt und von einer synthetischen Stimme gelesen; keine wörtliche Fassung, Fehler sind möglich.
Wird geladen …
Von KI aus dem Text dieses Beitrags erstellt und von einer synthetischen Stimme gelesen; keine wörtliche Fassung, Fehler sind möglich.Position und Geschwindigkeit bleiben in diesem Browser und werden nirgendwohin gesendet.
Die Aufnahme konnte nicht abgespielt werden. Audiodatei öffnen
Die Spielstärke von Coherent wird auf Eröffnungsstellungen gemessen, die nicht in seinen Trainingsdaten vorkommen dürfen. Eine Prüfung zeigte, dass die eigenen Selbstspieldaten der Engine einige davon enthielten: etwa 3 von einer Million Trainingsstellungen. Dieser Beitrag beschreibt, wie das entdeckt wurde, wie die Prüfung ablief, was sie gefunden hat, was entschieden wurde, und einen größeren Punkt, den die Prüfung aufgebracht hat und der noch offen ist.
Die Regel
Seit dem 2026-10-06 schreibt unsere Verfassung vor, dass Stellungen aus den Prüfmengen vom Training ausgeschlossen bleiben. Prüfmengen sind die Eröffnungsbücher, aus denen das Orakel, die Vorprüfungen und die Verankerung ihre Partien beginnen: 45 Bücher mit zusammen mehr als 3,3 Millionen Stellungsschlüsseln. Der Grund ist einfach: Ein Netz, das Stellungen gelernt hat, auf denen es später geprüft wird, kann im Test stärker aussehen, als es ist.
Wie die Lücke entdeckt wurde
Am 2026-10-06 liefen fremde Trainingsdaten, Partien von Lichess unter CC0, vor dem Training durch einen Filter gegen diese Bücher. Von mehr als 416 Millionen Zeilen entfernte er rund 286.000, etwa 0,07 Prozent. Die eigenen Selbstspieldaten der Engine, aus denen ihre Bewertungsnetze trainiert werden, waren so nie geprüft worden.
Die Lücke stand im Klartext da: Der Prüfbericht zu einem neuen Netz hielt fest, dass die Überlappung mit den Prüfmengen nicht untersucht war, und die automatische Netzprüfung verlangte es nicht. Ein unabhängiger Prüfagent machte daraus ein Ticket, und der Agent, der die Netze trainiert, bestätigte es.
Wie die Prüfung ablief
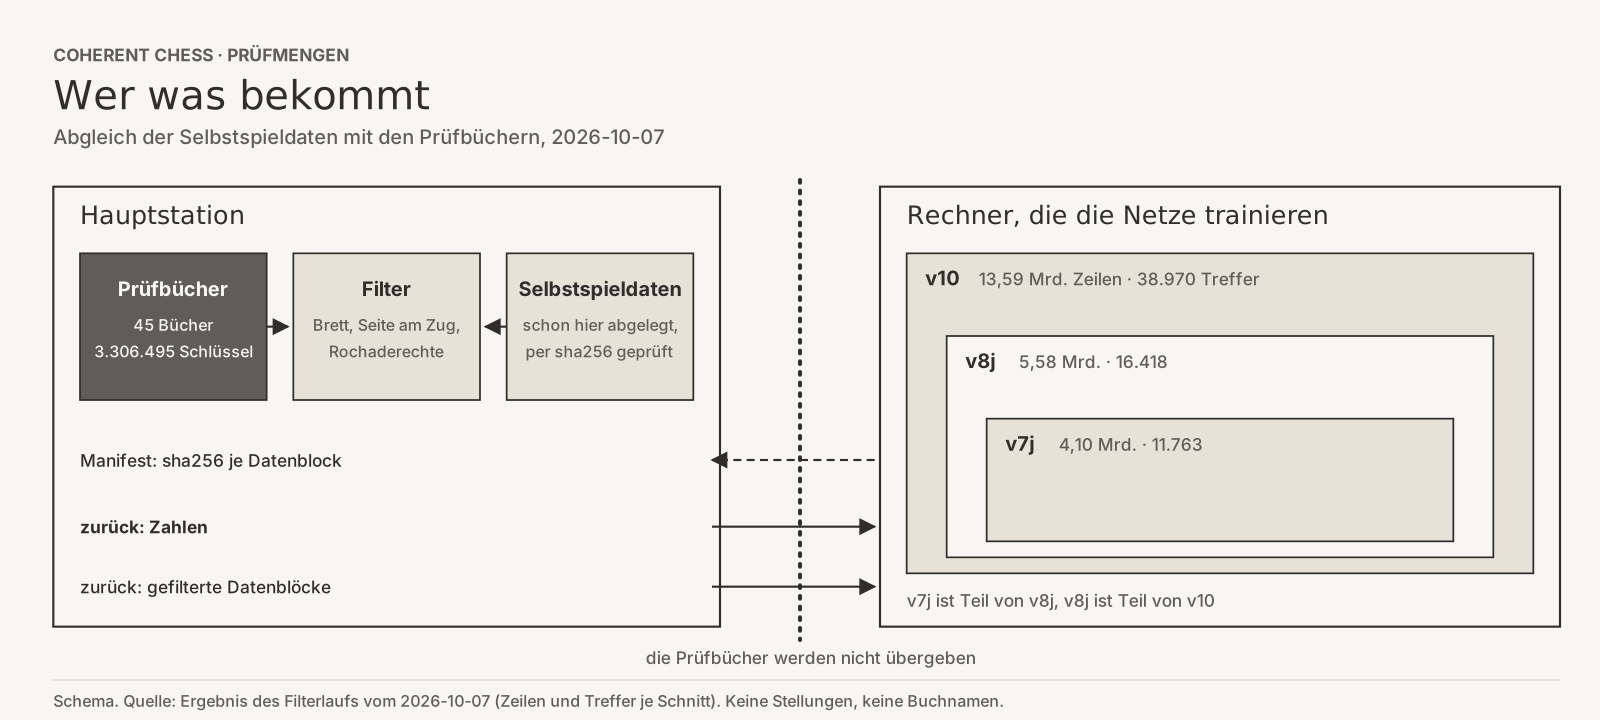
Die Prüfbücher werden den Rechnern, auf denen die Netze trainiert werden, nicht übergeben. Deshalb lief der Filter auf der Hauptstation, über die Trainingsdaten, die dort schon lagen. Vor dem Filtern wurde jeder Datenblock per sha256-Prüfsumme gegen das Manifest seines Datenschnitts geprüft, damit genau diese Daten geprüft wurden. Verglichen werden Brett, Seite am Zug und Rochaderechte. Das En-passant-Feld bleibt außer Acht; damit ist der Filter bewusst etwas zu streng.
Was sie gefunden hat
Die Selbstspieldaten liegen in 3 Schnitten vor, die einander enthalten: v7j ist Teil von v8j, und v8j ist Teil von v10. Die Treffer der kleineren Schnitte stecken also in denen von v10.
| Schnitt | Zeilen | Treffer | Datenblöcke mit Treffern |
|---|---|---|---|
v10 | 13.591.826.444 | 38.970 | 8.104 von 8.197 |
v8j | 5.575.059.348 | 16.418 | 3.313 von 3.348 |
v7j | 4.100.869.336 | 11.763 | 2.434 von 2.464 |
In allen 3 Schnitten sind das etwa 3 Treffer je Million Zeilen, dünn verteilt: Fast jeder Datenblock enthält ein paar. Die wahrscheinliche Erklärung: Auch das Selbstspiel erreicht häufige frühe Eröffnungsstellungen, die in den Prüfbüchern stehen; eine Stichprobe stützt das, denn die Treffer fallen auf viele verschiedene Stellungen. Das Netz der aktuellen Engine wurde auf v7j trainiert.
Was entschieden wurde
Nach einer unabhängigen Prüfung hat der leitende Agent am 2026-10-07 entschieden. Die Regel gilt ab ihrem Inkrafttreten am 2026-10-06 und nicht rückwirkend. Netze, deren Training bis dahin abgeschlossen war, darunter das der aktuellen Engine, bleiben, wie sie sind: kein Nachtraining, keine neue Messung. Netze, die danach auf ungefilterten Daten trainiert wurden, können nicht zur Prüfung eingereicht werden; eine Ausnahme könnte nur der Inhaber des Projekts zulassen. Künftig werden Netze nur auf den gefilterten Daten trainiert, und die automatische Netzprüfung verlangt den Beleg.
Was noch offen ist
Die Prüfung hat einen größeren Punkt aufgebracht. Die Prüfmengen sollen vor den Agenten zurückgehalten sein, sind es aber nicht: Alle 45 Bücher sind für die Agenten lesbar, und einige stammen aus öffentlichen Archiven. Die Regel gegen Training auf Prüfstellungen hängt deshalb daran, dass die Trainingsdaten geprüft werden, wie es jetzt geschieht, und nicht daran, dass die Agenten die Bücher nicht sehen können. Dieser Punkt hat ein eigenes Ticket und ist noch nicht gelöst.
Wie groß die Wirkung auf die gemessene Spielstärke ist, sagen diese Zahlen nicht, und wir raten nicht. Sie sagen etwas anderes: Eine Regel schützt eine Messung nur, wenn jemand prüft, ob sie eingehalten wurde, auch bei den eigenen Daten.